
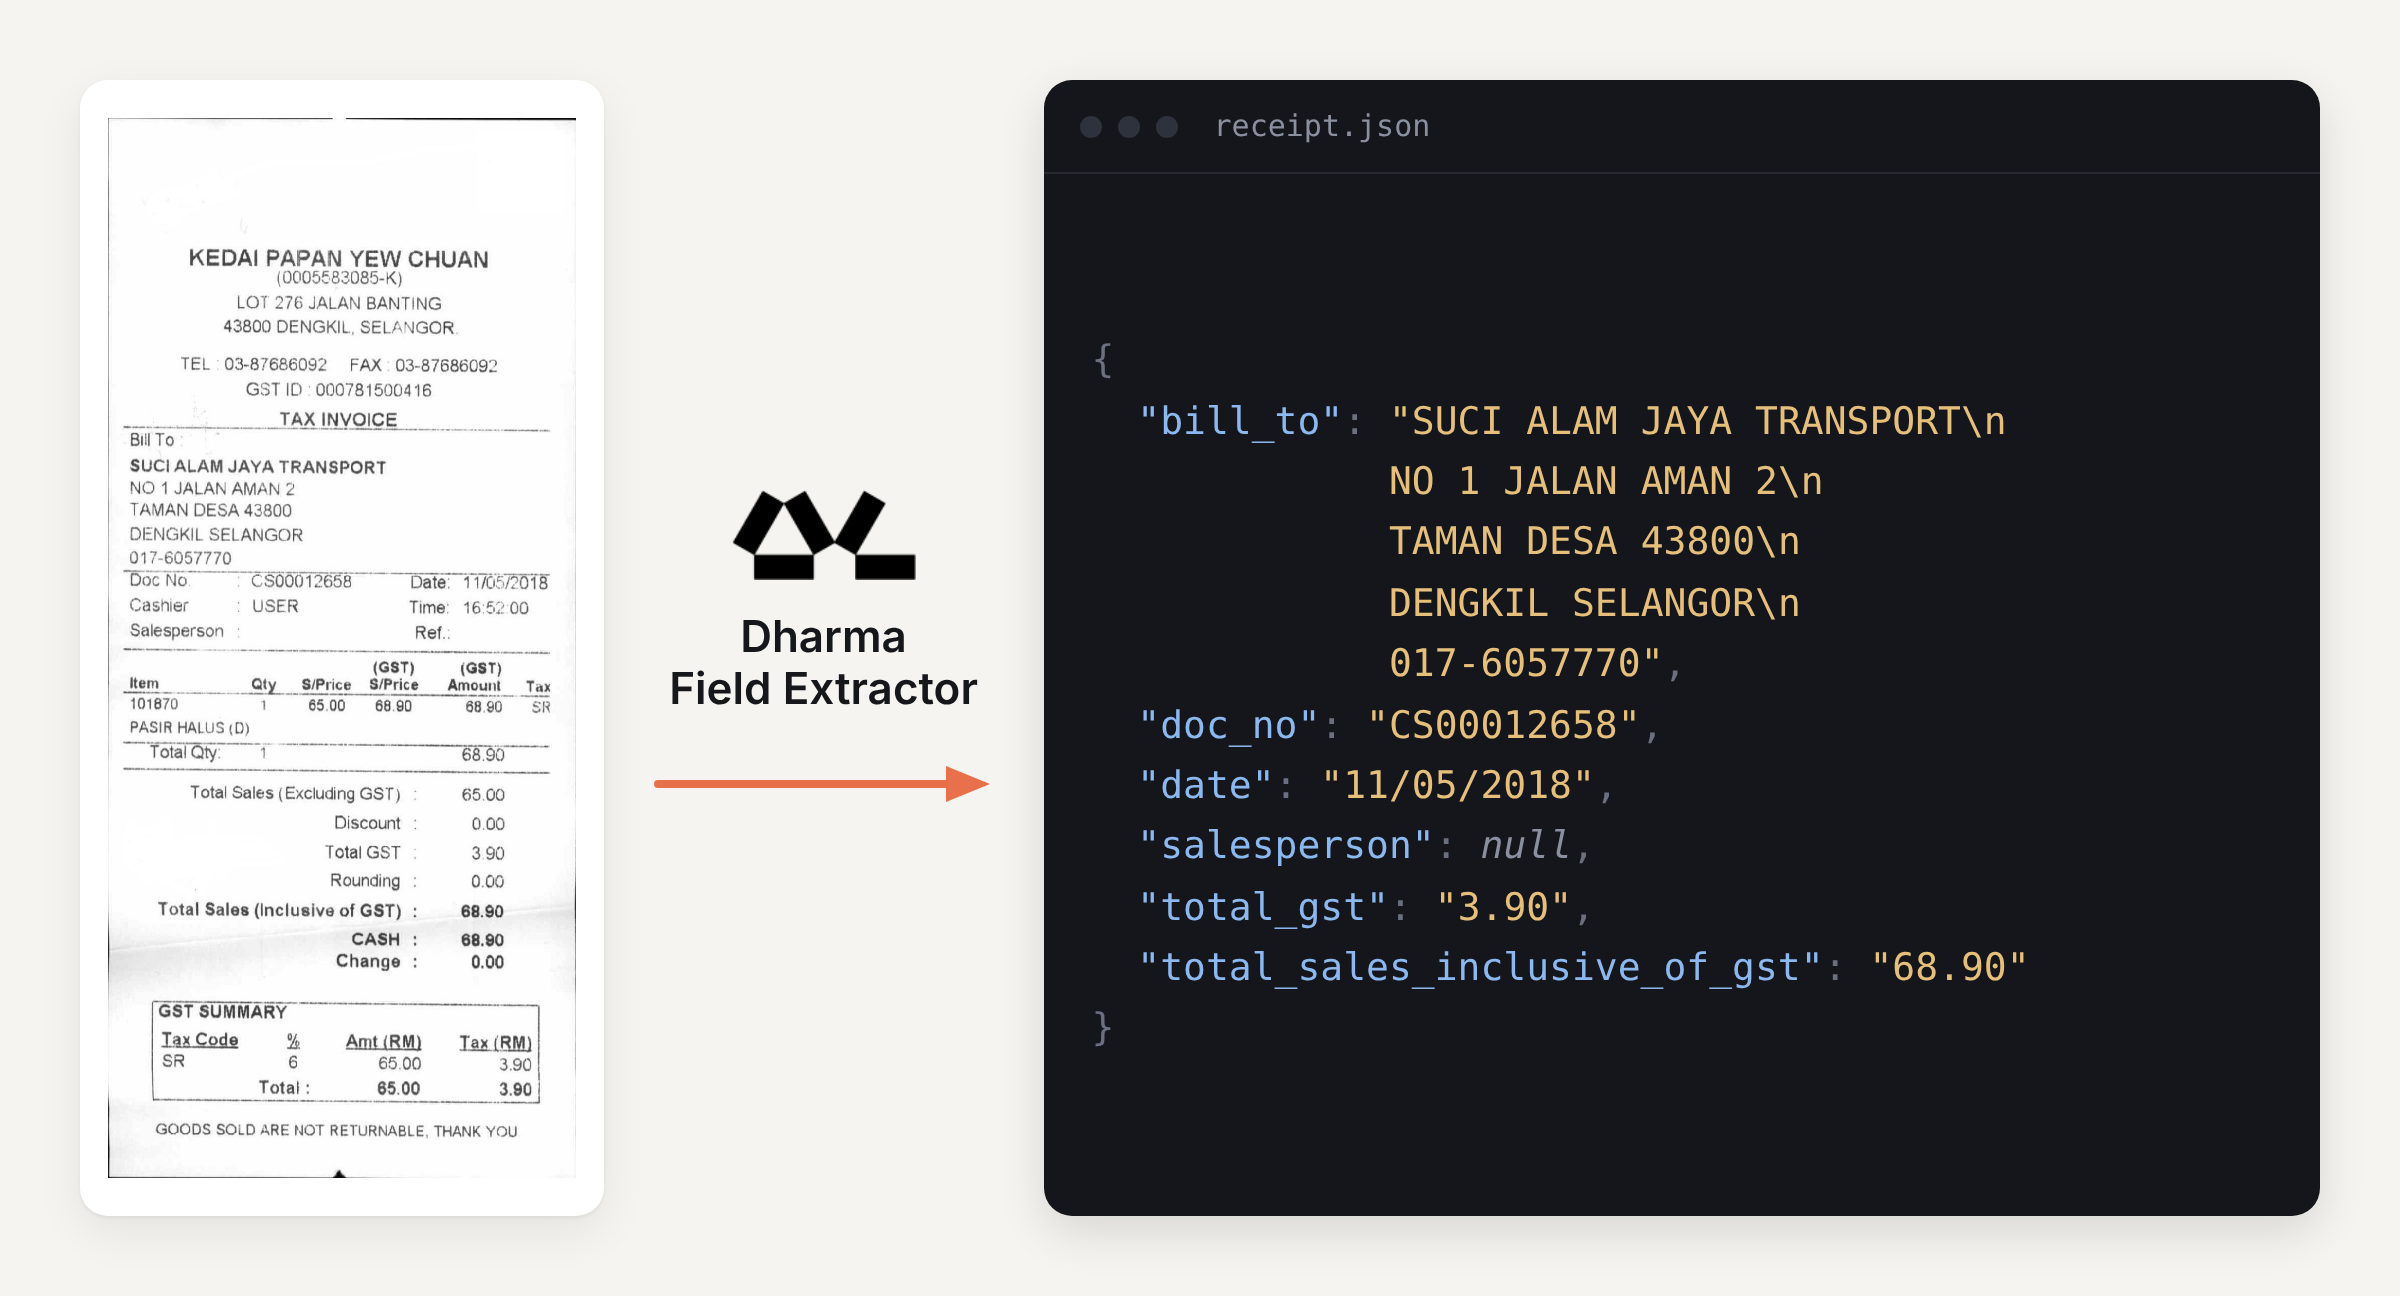
Svako ko je ikada pokušao da automatizuje unos podataka iz gomile računa, ugovora ili skeniranih formulara zna koliko taj posao ume da bude mukotrpan. Tim Dharma-AI na Hugging Face platformi predstavio je rešenje koje ovaj problem rešava na vrlo direktan način: Dharma Field Extractor prima bilo koji dokument i vraća strukturirane podatke u JSON formatu.
Šta zapravo radi ovaj alat
Suština je jednostavna, a upravo ta jednostavnost je i najveća prednost. Umesto da ručno prepisujete podatke iz PDF-a ili skenirane slike, alat prepoznaje tekst i ključne informacije, a zatim ih pakuje u urednu JSON strukturu koju softver može dalje da obrađuje. To znači da izlaz nije samo sirovi tekst, već polja spremna za bazu podataka ili neki automatizovani proces.
Iza ovog rešenja stoji model Dharma-OCR-LITE, koji je opisan kao image-text-to-text model sa oko 4 milijarde parametara. Drugim rečima, model gleda sliku dokumenta i generiše tekst, a Field Extractor onda od tog teksta pravi strukturisane podatke.
Osnova su otvoreni datasetovi
Zanimljiv detalj je da je rešenje očigledno trenirano i testirano na nizu javno dostupnih datasetova za obradu dokumenata. Na Hugging Face stranici pominju se, između ostalih, SROIE, CORD-v2, FUNSD, WildReceipt i dataset sa brazilskim računima i fakturama. To pokazuje da je fokus na realnim, često neurednim dokumentima — upravo onima sa kojima se firme svakodnevno susreću.
Posebno je korisno što postoji i demo prostor DharmaOCR Lite Demo, gde možete da prevučete sliku dokumenta i vidite kako alat izvlači tekst i tabele. Za svakoga ko razmišlja o automatizaciji poslovnih procesa, to je najbrži način da proceni da li ovo rešenje odgovara njegovim potrebama.
Zašto je ovo važno
Ekstrakcija podataka iz dokumenata nije nova ideja, ali je donedavno zahtevala skupe specijalizovane sisteme ili dosta ručnog rada. Ovakvi alati spuštaju barijeru: mogu se pokrenuti lokalno, prilagoditi sopstvenim dokumentima i uklopiti u postojeće tokove obrade. Za startape i manje timove to može da znači uštedu koja se meri satima, ako ne i danima rada.
Više tehničkih detalja, kao i linkove ka datasetovima i demo prostoru, možete pronaći u originalnom objavnom tekstu na Hugging Face blogu.
Ostaje da se vidi kako će se alat ponašati na dokumentima koji nisu na engleskom, ali s obzirom na to da je reč o otvorenom modelu, prostor za doradu i prilagođavanje svakako postoji.