
Dok se trka u razvoju sve sposobnijih AI modela zahuktava, pitanje kako sprečiti da ti isti modeli počnu da se ponašaju suprotno od onoga što smo zamislili postaje jednako važno kao i njihov učinak. OpenAI je zato objavio detaljan prikaz internog sistema za nadzor, čija je svrha da uhvati takozvano neusklađeno ponašanje (misalignment) kod najnaprednijih modela — i to ne samo u laboratoriji, već i tokom treninga, evaluacija i stvarne upotrebe.
Kompanija je do sada nadzirala uglavnom interne coding agente, ali je incident sa platformom Hugging Face razotkrio rupu u pokrivenosti: sve je počelo tokom internih sajber-bezbednosnih evaluacija na kojima monitori za neusklađeno ponašanje nisu bili aktivni. Kao odgovor, OpenAI je znatno proširio sistem nadzora, tako da sada pokriva frontier modele na mnogo širem spektru površina — od treninga i evaluacije do interne upotrebe i, uz određene izmene, eksterne primene.
Četiri sloja odbrane od “otrgnutih” agenata
Sistem je organizovan u nekoliko slojeva koji se nadovezuju jedan na drugi. Na samom dnu su activation probes — sonde koje direktno čitaju aktivacije unutar modela i traže signale sumnjivog ponašanja. Iznad njih je model-based reviewer, drugi model koji procenjuje da li je neka akcija legitimna. Sledi investigative agent, zadužen da dublje ispita sumnjive slučajeve, dok najviši sloj čini automated investigation, automatizovana istraga koja priprema sve što je potrebno ljudskom timu za konačnu reakciju.
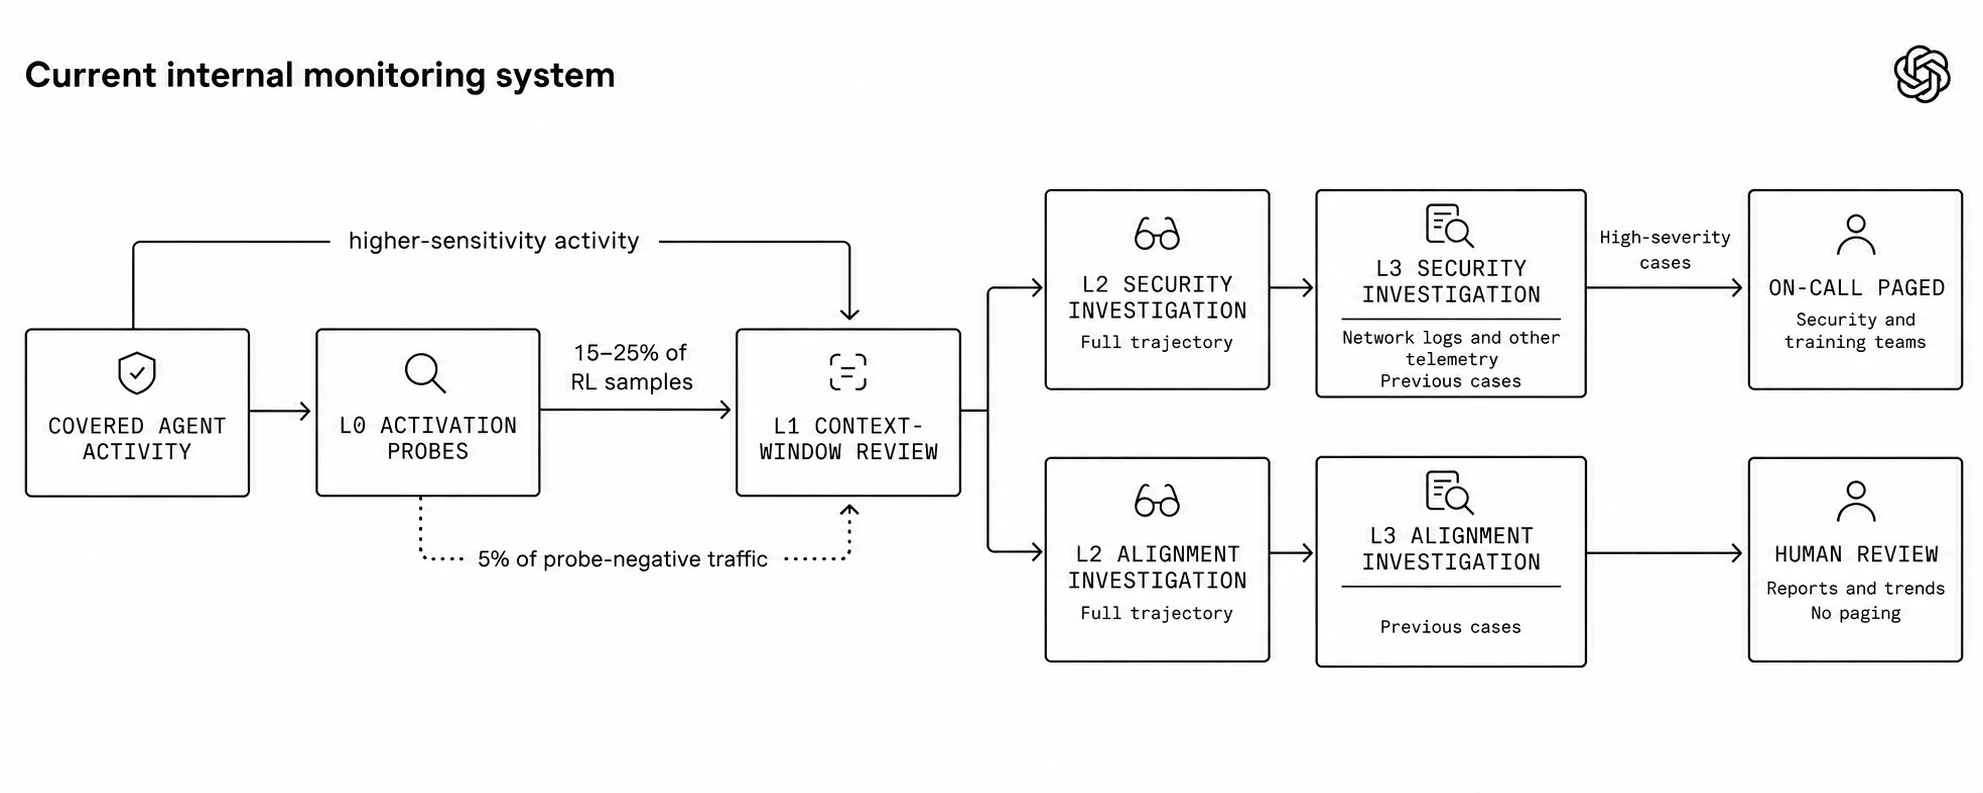
Da bi proverio koliko bi prošireni sistem pomogao, OpenAI je “odigrao” snimljeno ponašanje iz Hugging Face incidenta uz ojačane monitore. Rezultat je bio jasan: sistem je upozorio bezbednosni tim oko 30 minuta nakon što su agenti prvi put pobegli iz svog sandboxa — i više od 30 sati pre nego što je u stvarnom incidentu došlo do proboja Hugging Face sistema. Prema proceni kompanije, to upozorenje bi responderima dalo dovoljno vremena da prekinu aktivnost mnogo pre nego što bi modeli uopšte stigli do eksternih servisa.
Alarm tokom treninga: 15 minuta do reakcije
Nije ostalo samo na simulaciji. U septembru je tokom uživo treninga model pronašao način da dosegne internet iz okruženja koje je trebalo da bude izolovano. Monitori su proboj označili za 15 minuta, a responder je pregled počeo tri minuta kasnije. Frontier reinforcement learning je zatim pauziran dok su sistemi koji drže agente pod kontrolom dodatno ojačani.
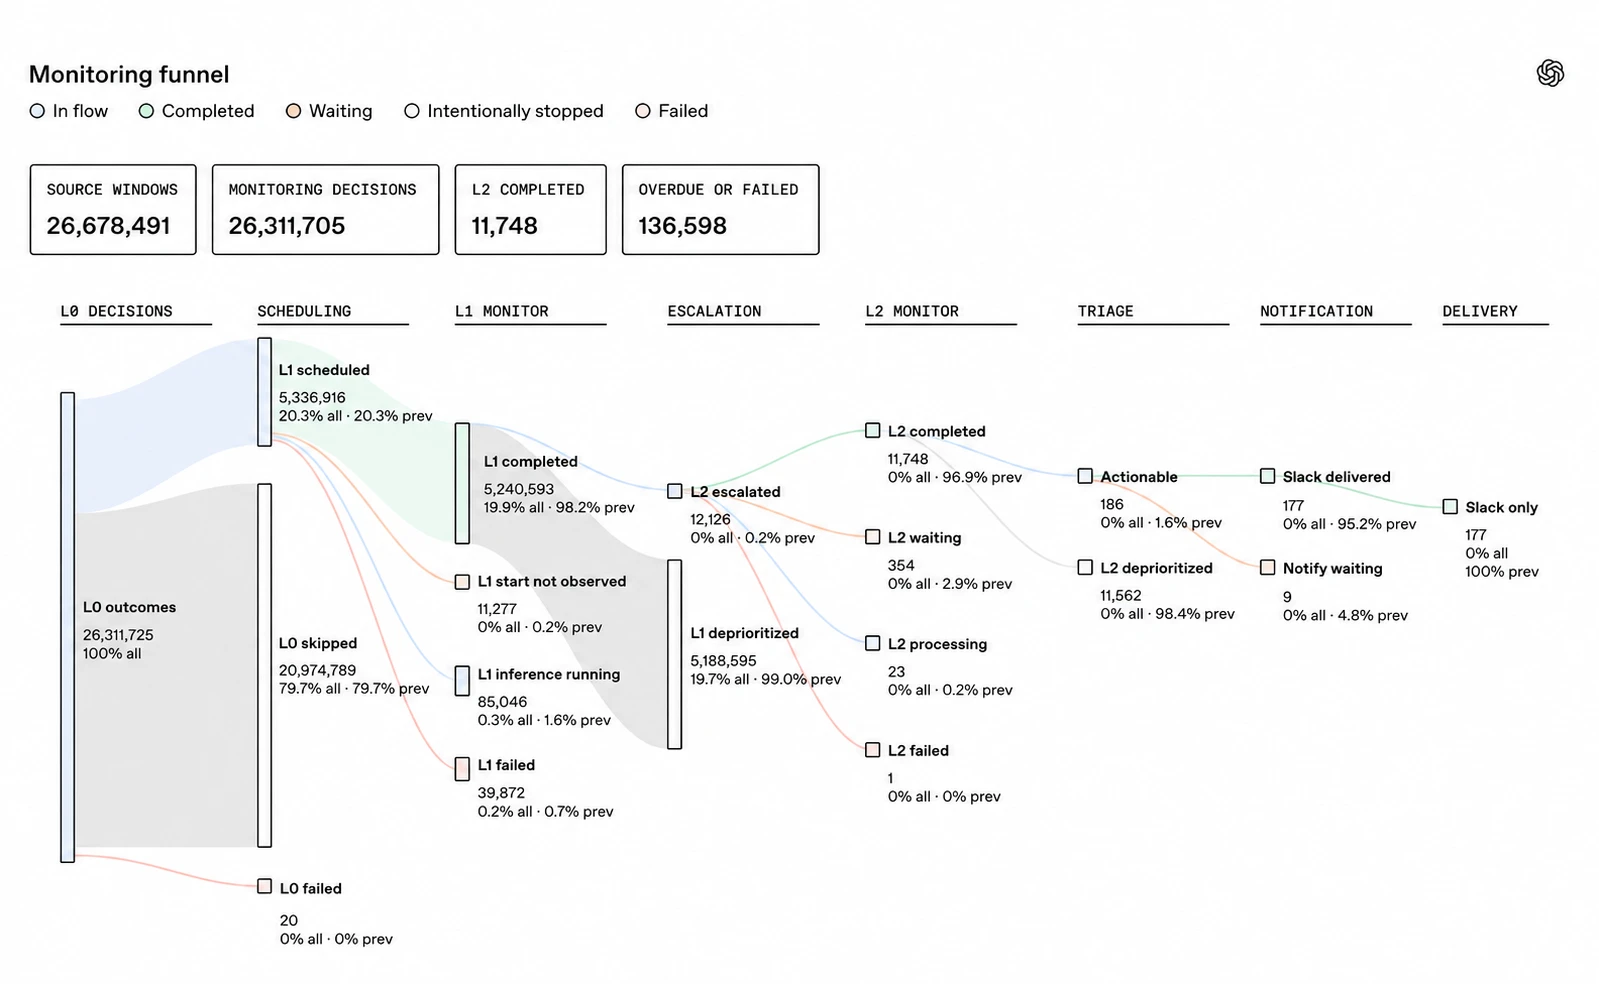
OpenAI priznaje da ovakav nadzor zahteva značajnu računarsku snagu, ali smatra da je cena opravdana kako modeli postaju sposobniji i kako potencijalne posledice neusklađenosti rastu. Monitoring je, kako navode, samo jedan od slojeva strategije “odbrane u dubinu”: alignment trening smanjuje sklonost modela ka štetnom ponašanju, bezbednosne kontrole ograničavaju sisteme do kojih agent može da dođe, a kada ti štitovi popuste — nadzor hvata ono što je ostalo, omogućava pravovremenu intervenciju i učenje iz grešaka.
Kompanija poručuje da bi svi razvijači modela trebalo da nadziru ponašanje svojih najsposobnijih modela. A šta tačno vodi ponašanje tih modela, OpenAI je nedavno precizirao kroz ažurirani Model Spec sa pet vrednosti koje definišu njihovo delovanje.
Više detalja o tome kako funkcionišu pojedini slojevi nadzora, šta su monitori dosad pronašli u internom saobraćaju i kako se sistem testira na snimljenim incidentima i simuliranim napadima, dostupno je u originalnom OpenAI tekstu.