
Tim Hugging Face-a, koji aktivno doprinosi razvoju PyTorch-a, objavio je detaljan pregled novog izdanja PyTorch 2.15, a vest je posebno zanimljiva svima koji modele veštačke inteligencije pokreću na Mac računarima. Fokus ovog izdanja je MPS backend (Metal Performance Shaders), čiji je cilj da Mac pretvori u ozbiljnu platformu za treniranje i izvršavanje PyTorch modela.
Da bi došli do ovih poboljšanja, inženjeri su pokretali stvarne modele sa Hugging Face Hub-a iz domena jezika, slika i videa, pronalazili mesta gde MPS zaostaje i popravljali ih direktno u PyTorch-u — sve češće zamenjujući MPSGraph namenskim Metal kernelima.
FP8 konačno stiže na Mac
Najveća novost je podrška za FP8 format. Vrednosti tipa float8_e4m3fn sada se čuvaju u upola manje prostora nego BF16, a uz skalirano matrično množenje rade i sve ostale operacije koje su do sada bile dostupne na CUDA i CPU platformama. To je važan korak ka efikasnijem lokalnom radu sa velikim modelima.
MoE modeli dekodiraju 5–6,5 puta brže
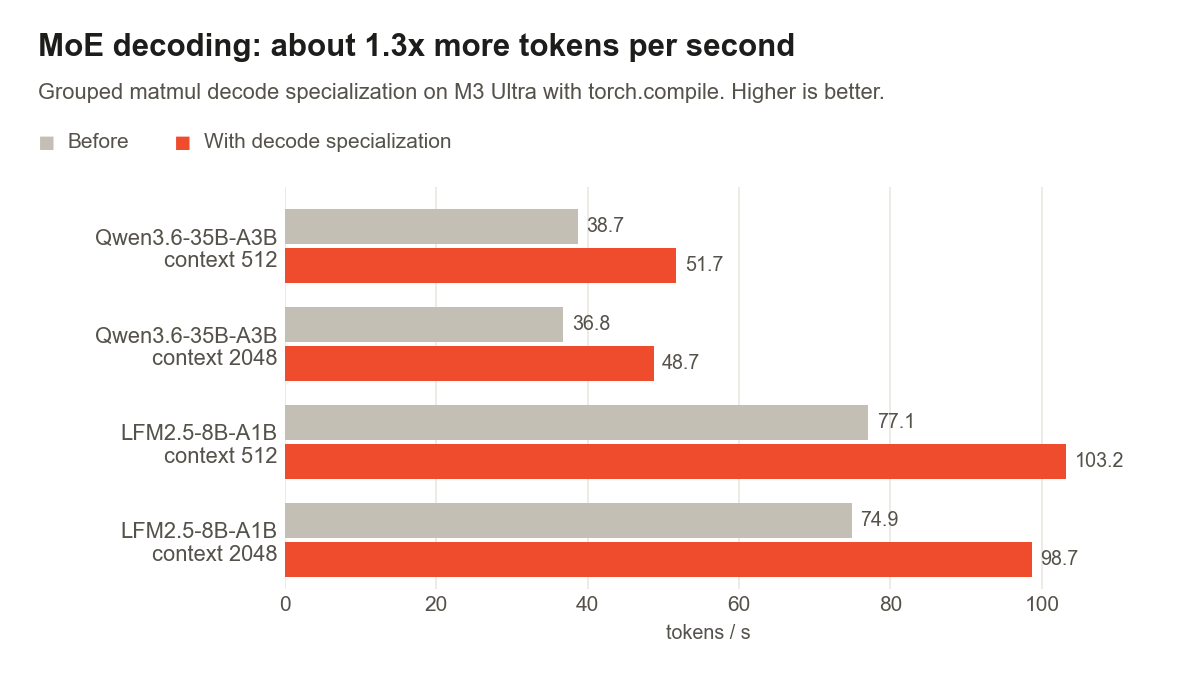
Modeli sa mešavinom eksperata (Mixture-of-Experts) ostvarili su najdramatičniji skok. Zahvaljujući nativnom grupisanom matričnom množenju sa posebnom putanjom za dekodiranje, manjem broju GPU-CPU sinhronizacija i bržem top-k rutiranju, rezultati su impresivni. Na M3 Ultra čipu uz torch.compile, Qwen3.6-35B-A3B skače sa 9,4 na 61,3 tokena u sekundi, dok LFM2.5-8B-A1B ide sa 23,6 na čak 123,6 tokena u sekundi.
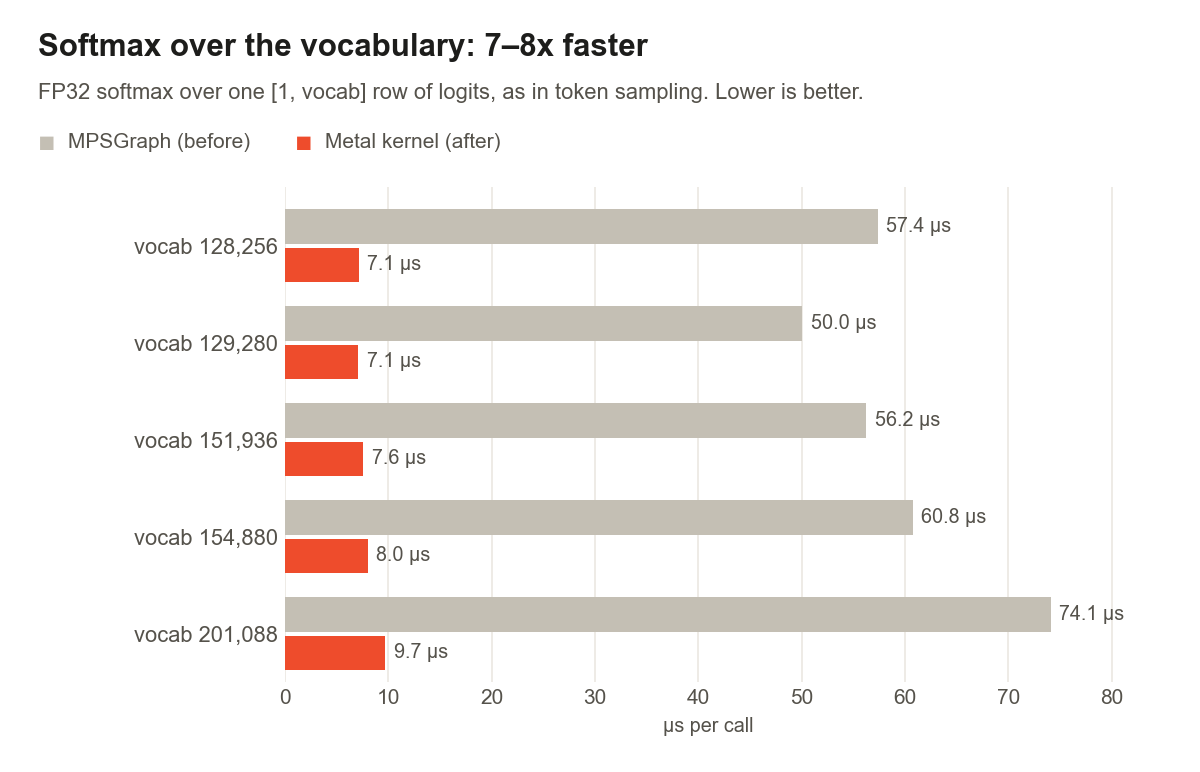
Ni gušći modeli nisu zanemareni — linearne operacije sa jednim redom sada koriste specijalizovane matrica-vektor kernele, a softmax nad vokabularom je oko 8 puta brži. Sve to zajedno znači manje vremena po tokenu za svaki LLM.
Video generisanje koje staje u memoriju
Jedan od najupečatljivijih primera optimizacije tiče se video generisanja. Dekodiranje videa pomoću tiled VAE kod modela Wan2.2 ranije je guralo memoriju drajvera do neverovatnih 270 GiB. Sada maksimum dostiže oko 8 GiB — što je razlika koja od nemoguće misije pravi realnu opciju na prosečnom Mac računaru.
Više linearne algebre na GPU-u
Izdanje donosi i ozbiljna unapređenja u domenu linearne algebre: kompleksne LU dekompozicije i trougaone solve operacije, brže inverzije malih matrica i bržu QR dekompoziciju. Tu su i brže putanje za konvolucije, padding, dropout, interpolaciju unazad i redukcije — što će osetiti svi koji na Macu treniraju modele, ne samo one koji ih izvršavaju.
Više kontrole iz Pythona i nova ograničenja
Razvojni tim je dodao i javne MPS stream-ove i pouzdanije merenje vremena događaja, što programerima daje veću kontrolu nad izvršavanjem. Važno je napomenuti i nova sistemska ograničenja: MPS sada zahteva macOS 15 ili noviji, a PyTorch 2.15 traži Python 3.11 ili noviji.
Za kraj, autori najavljuju šta donosi PyTorch 2.16: attention koji u potpunosti radi na Metal-u, još migracija sa MPSGraph na Metal i dodatno ubrzanje dekodiranja LLM modela. Detaljan tehnički pregled dostupan je na zvaničnom Hugging Face blogu.