
Hugging Face je napravio korak koji bi mogao ozbiljno da ubrza razvoj autonomnih AI agenata. Na svoju platformu dodali su RL Environments — poseban hub namenjen okruženjima za reinforcement learning (učenje pojačavanjem), koja postaju jedan od najtraženijih resursa u eri velikih jezičkih modela.
Ako pratite svet AI-a, verovatno znate da su se faze treniranja modela menjale: prvo su dominirali ogromni skupovi podataka za prethodno treniranje, zatim uputstva i ljudske povratne informacije (RLHF), a sada u fokus ulaze interaktivna okruženja u kojima model uči kroz pokušaje i greške. Upravo tu “prazninu” Hugging Face želi da popuni.
Šta su zapravo RL okruženja?
Za razliku od klasičnih dataseta koji sadrže gotove parove pitanje–odgovor, RL okruženje je simulirani svet u kom agent izvršava akcije i dobija nagradu ili kaznu. To može biti terminal u kom model rešava zadatke iz programiranja, simulator koji testira logičko zaključivanje ili okruženje u kom agent mora da prati složena uputstva.
Drugim rečima — umesto da model samo “pročita” tačan odgovor, on ga mora sam izboriti. To je ključna razlika koja stoji iza uspeha modela poput najnovijih reasoning sistema.
Šta se sve nalazi u hubu
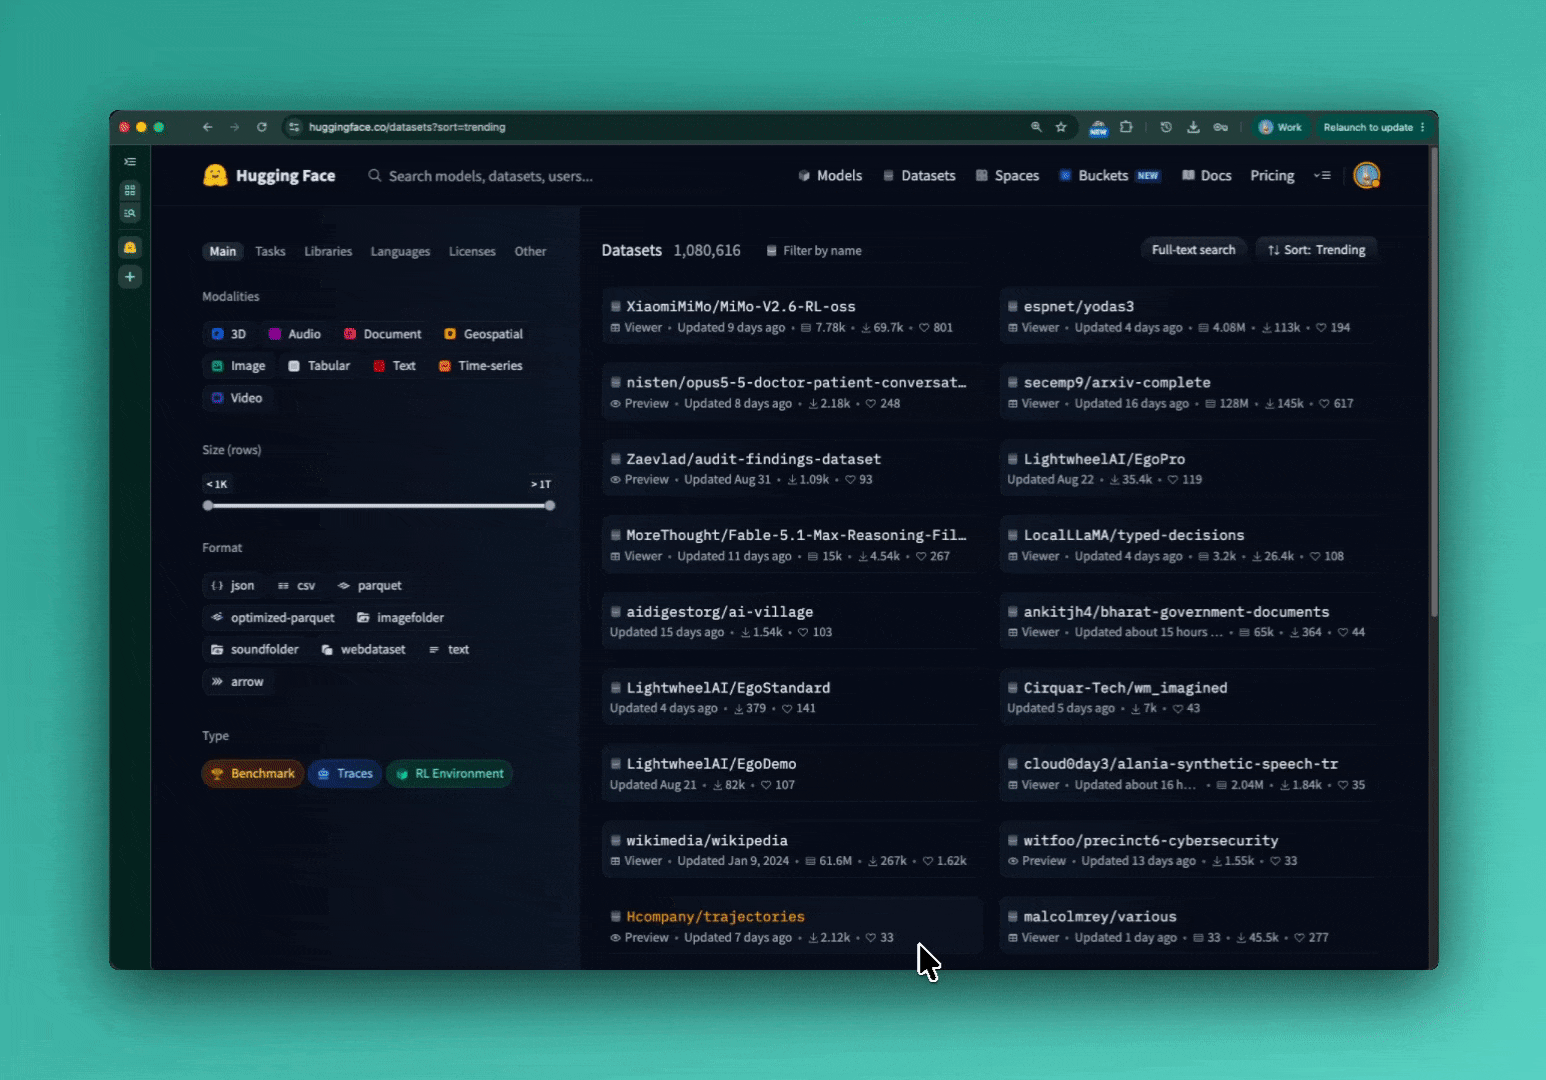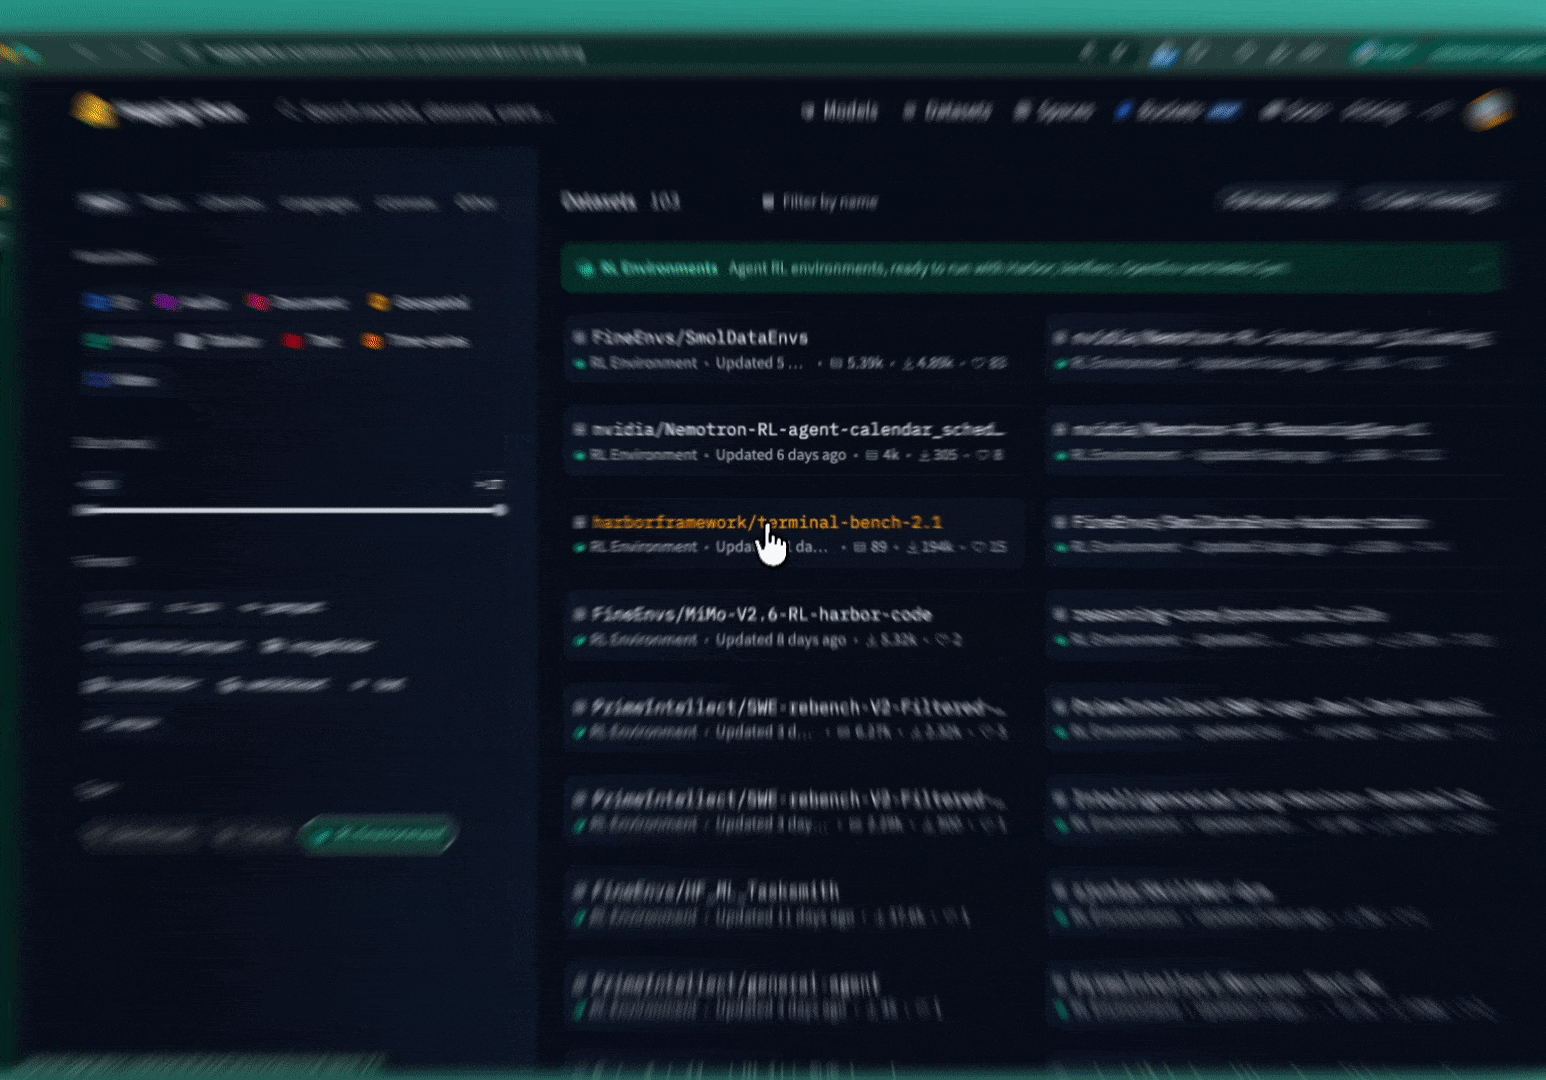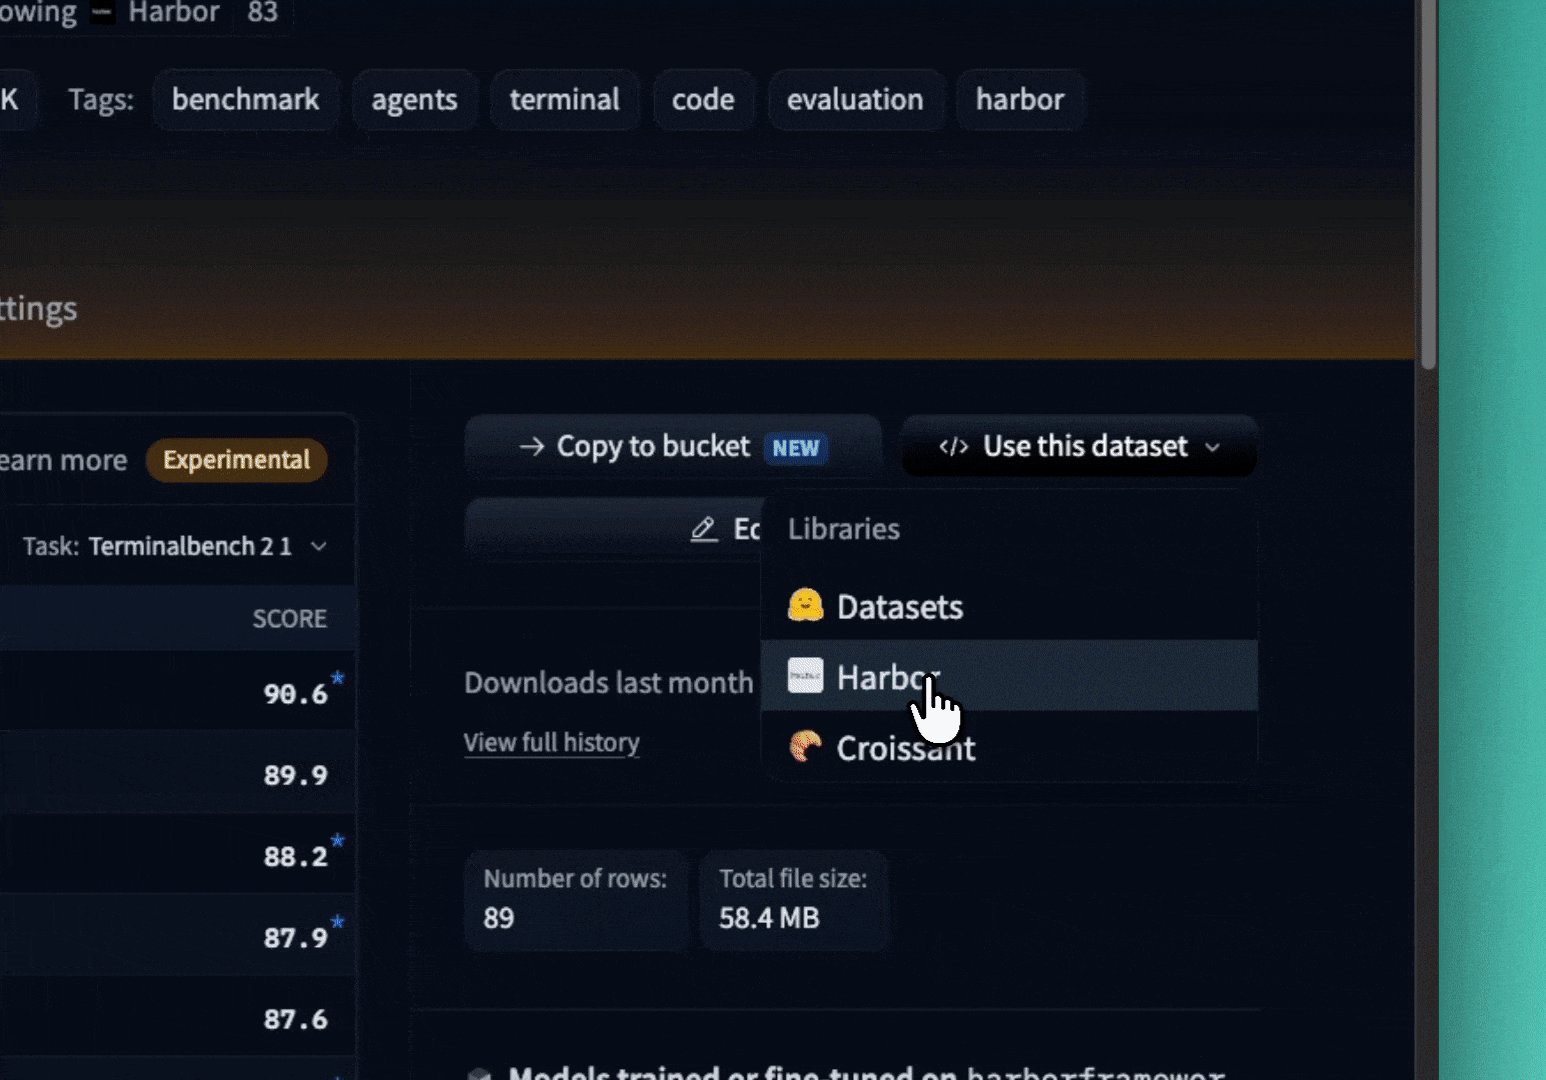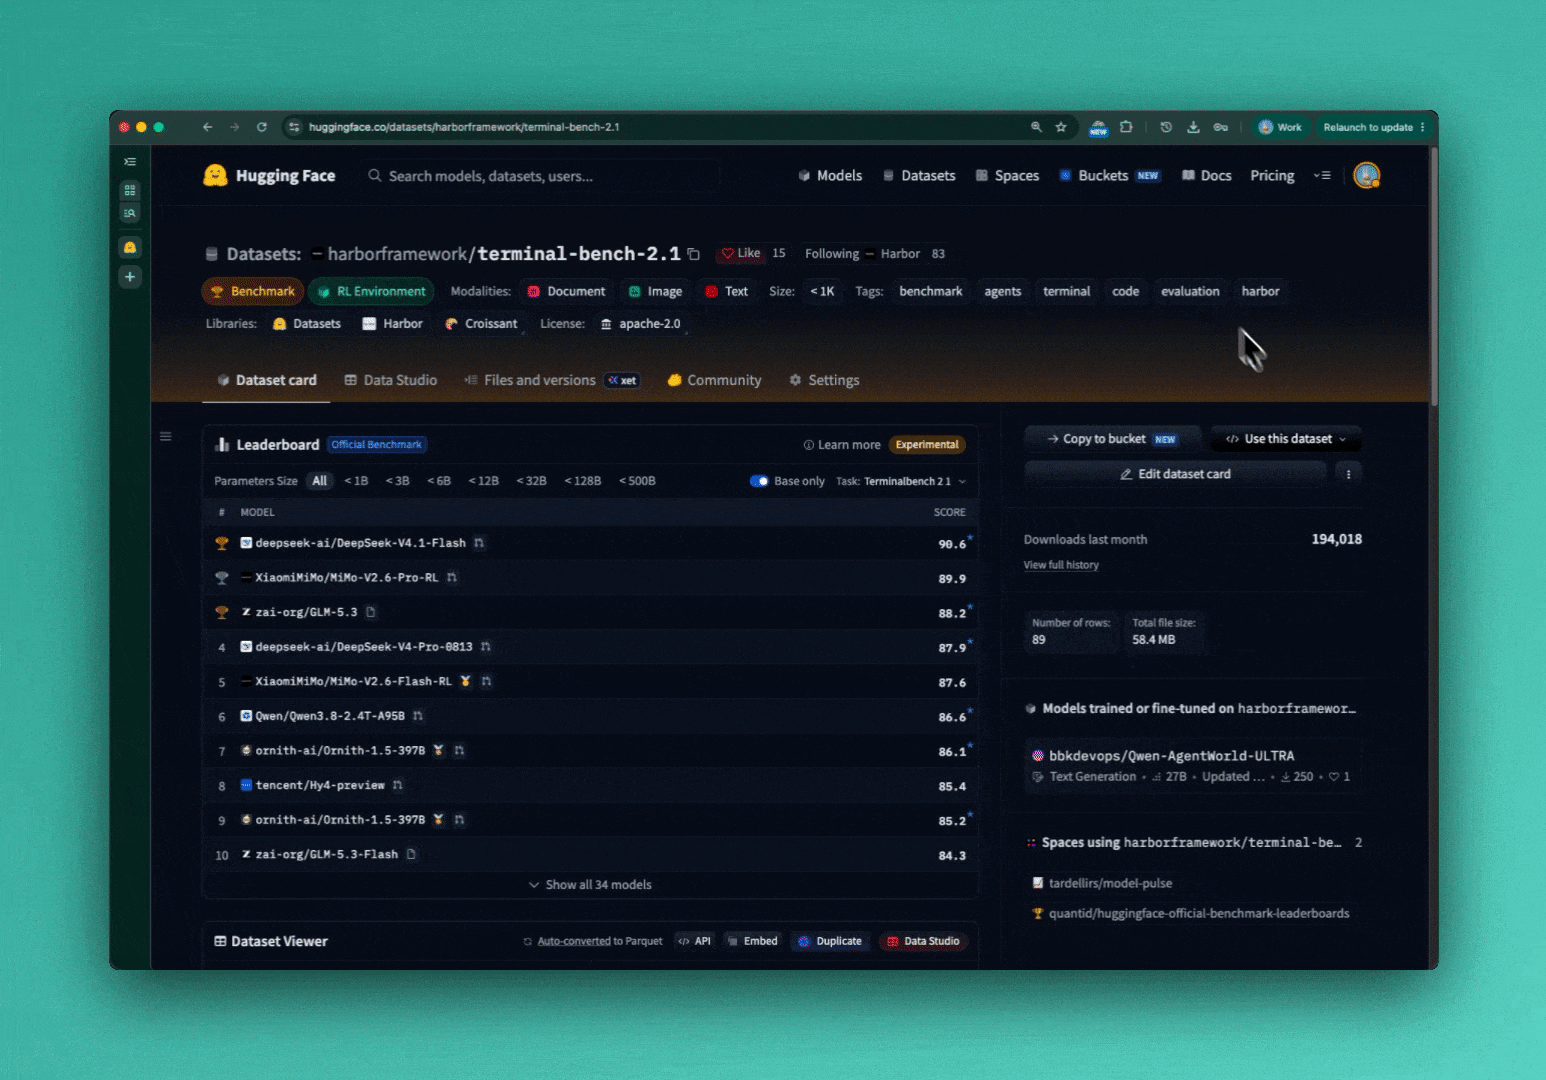
Na novom hubu već se mogu naći konkretni primeri, i to ne mali. Tu su okruženja kao što su PrimeIntellect/Scale-SWE-Verified sa preko 17.000 primera, PrimeIntellect/R2E-Gym-Subset-Verified i PrimeIntellect/Multi-SWE-RL-Verified, sva ažurirana u poslednjih nekoliko dana. Tu je i NVIDIA/Nemotron-RL-instruction_following-structured_outputs, namenjen treniranju modela da pouzdano prate instrukcije i vraćaju strukturisane izlaze.
Pored gotovih okruženja, tu su i benchmarkovi poput harborframework/terminal-bench-2.1 i skupova kao što je harbor-mix, koji služe za merenje koliko su agenti zaista sposobni da obave zadatke u realističnim uslovima. Uz to, Hugging Face je objavio i vodič pod nazivom “The ultimate guide to RL environments”, koji objašnjava kako se ovakva okruženja grade i skaliraju.
Zašto je ovo važno za domaću scenu
Do sada je ozbiljan RL trening bio rezervisan za timove sa dubokim džepovima — velike laboratorije i kompanije koje mogu sebi da priušte infrastrukturu i sopstvena okruženja. Centralizacija ovih resursa na jednom mestu menja jednačinu: manji timovi, pa i pojedinci, sada mogu da koriste proverena okruženja umesto da ih grade od nule.
Za startape i istraživačke grupe u regionu koji rade na AI agentima, ovo je konkretna olakšica. Umesto nedelja provedenih u pisanju simulatora i evaluacionih okvira, može se odmah preći na ono što je zaista teško — treniranje i fino podešavanje modela.
Hugging Face ovim potezom jasno stavlja do znanja gde vidi sledeću bitku u AI trci: ne u još većim modelima, već u kvalitetnim okruženjima u kojima ti modeli uče da budu korisni. Detalje i kompletnu listu možete pogledati na zvaničnom Hugging Face blogu.