
Istraživački institut Ai2 (Allen Institute for AI) objavio je Olmo-core 3, značajnu nadogradnju svog okvira za razvoj velikih jezičkih modela, sa potpuno redizajniranim sistemom za treniranje mixture-of-experts (MoE) arhitektura. Ova vest stiže sa Hugging Face bloga i predstavlja još jedan korak ka demokratizaciji razvoja veštačke inteligencije.
Suština problema kojim se Olmo-core 3 bavi je jednostavna, ali teška za rešavanje: treniranje velikih AI modela zahteva ogromne računarske resurse, što poskupljuje razvoj i čini ga nedostupnim manjim laboratorijama i akademskim istraživačima. MoE modeli nude efikasniji pristup — sadrže mnogo više naučenih komponenti (parametara), ali ne zahtevaju da svaki input koristi sve njih. Problem nastaje kada treba skladištiti ceo model u GPU memoriji i usmeravati inpute ka pravim ekspertima unutar klastera.
Šta donosi novi pristup?
Olmo-core 3 je napravio ključni zaokret u načinu na koji se modeli distribuiraju. Dok je prethodna MoE implementacija koristila fully sharded data parallelism (FSDP) — sistem koji je skupljao i ponovo delio težine modela za svaki mali batch podataka — nova verzija prelazi na distributed data parallelism (DDP). Eksperti ostaju stalno prisutni na GPU-ovima, a relevantni podaci se usmeravaju ka njima, čime se izbegava ponovno prikupljanje težina.
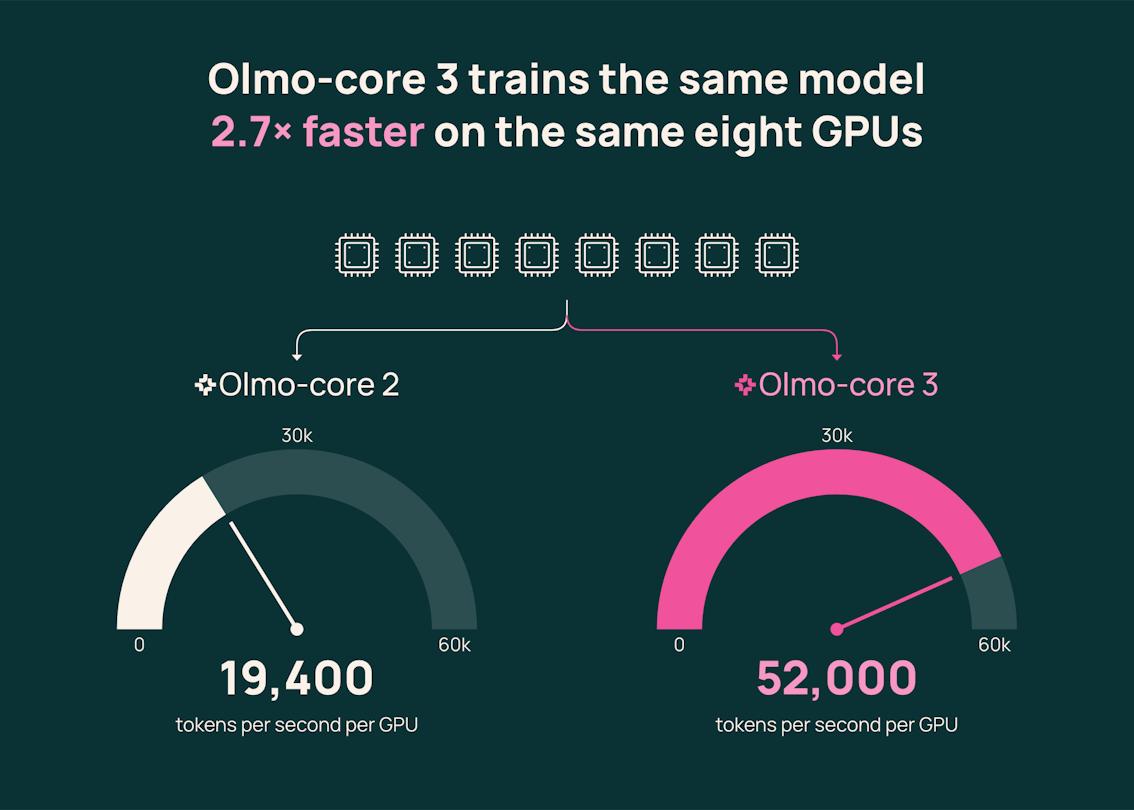
Rezultati su impresivni. U preliminarnom testu na osam NVIDIA B300 GPU-ova, MoE model sa 47 milijardi parametara obradio je 52.000 tokena po sekundi po GPU-u, u poređenju sa 19.400 kod starije implementacije — što je povećanje propusnosti od oko 2,7 puta.
Skaliranje do triliona parametara
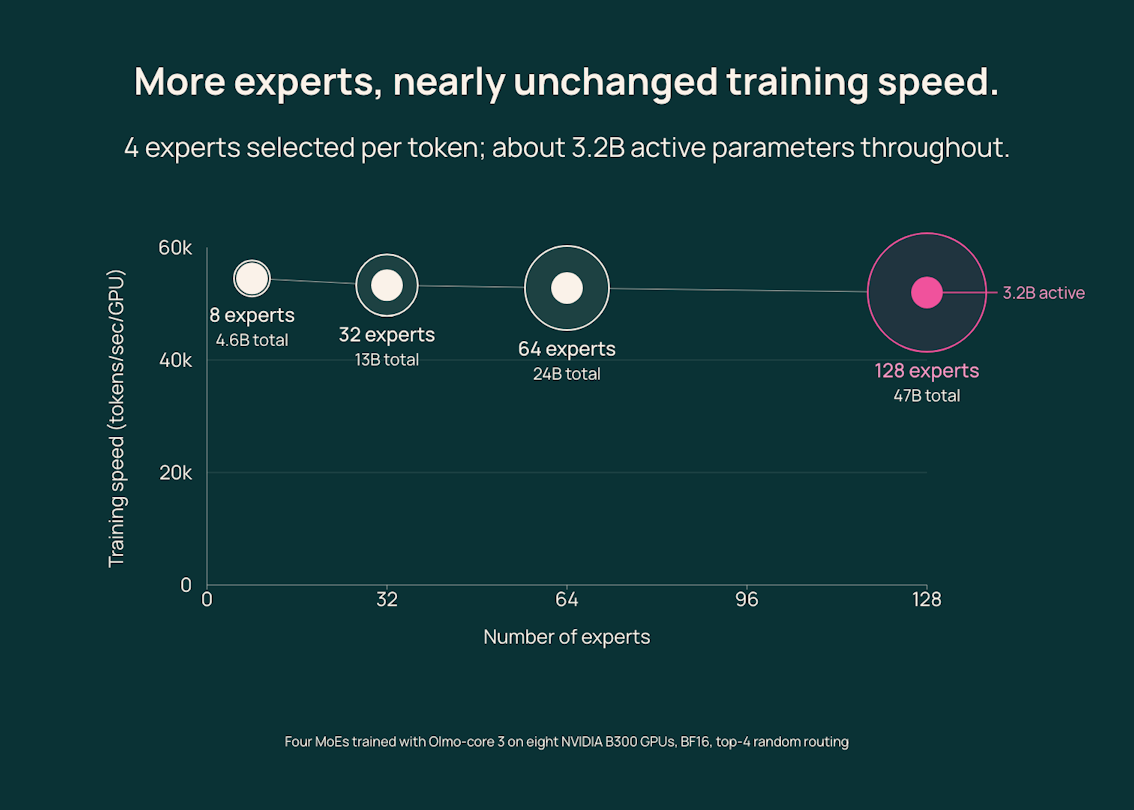
U jednom od benchmark testova, Ai2 tim je povećao broj eksperata sa 8 na 128, dok je istovremeno zadržao selekciju samo četiri eksperta po tokenu. Broj aktivnih parametara po tokenu ostao je stabilan na oko 3,2 milijarde, dok je ukupni kapacitet modela porastao sa 4,6 na 47 milijardi parametara — uz pad propusnosti treniranja manji od 5 procenata.
Ista infrastruktura testirana je i na preko trilion ukupnih parametara, što je granica koja je donedavno bila rezervisana samo za najveće kompanije sa praktično neograničenim budžetima.
Ai2 je ovim potezom nastavio tradiciju otvorenosti — kompletan tehnički izveštaj, kod i interaktivni demo dostupni su javnosti. Za razliku od NVIDIA Megatron-Core, koji je već etablirano rešenje za treniranje velikih MoE modela, Olmo-core 3 nudi integrisani stack unutar okvira koji stoji iza cele Olmo porodice modela.
Ovo je deo šireg trenda u AI zajednici gde otvoreni modeli i infrastruktura postepeno smanjuju jaz između velikih igrača i manjih istraživačkih timova. Više detalja može se pronaći u originalnom blog postu na Hugging Face-u.