
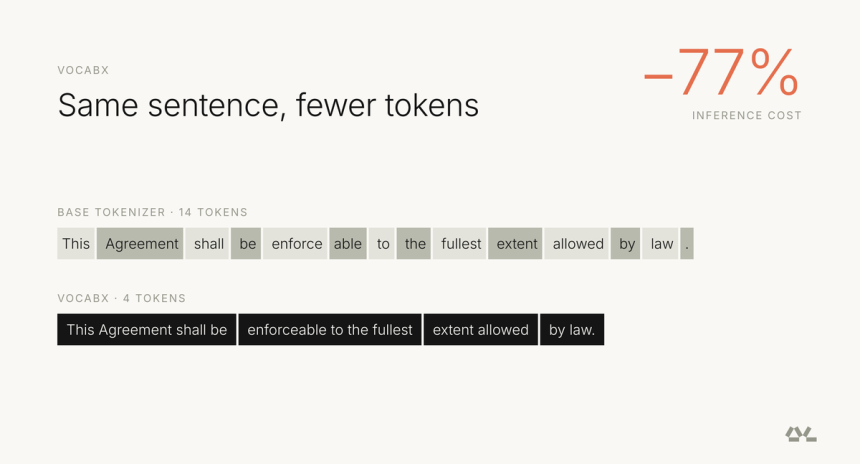
Tim istraživača iz Dharma-AI objavio je na Hugging Face blogu zanimljivo istraživanje koje bi moglo da promeni način na koji razmišljamo o troškovima AI modela. Reč je o specijalizaciji rečnika (vocabulary) kod malih jezičkih modela (SLM), što je dovelo do smanjenja troškova inferencije za čak 77 odsto u realnoj aplikaciji.
Kada se modeli specijalizuju za određenu domenu ili zadatak putem fine-tuninga na opštim open-source modelima poput Qwen i Gemma, oni nasleđuju rečnik koji je napravljen za mnoge domene i opšte primene. To može biti veliki problem, jer se tokenizer obično tretira kao fiksna karakteristika baznog modela — nasleđuje se i ostavlja na miru. Međutim, za model specijalizovan za jednu domenu, tokenizer može biti jedan od najvećih poluga za smanjenje troškova, a postavlja se pre bilo kog koraka treniranja.
Problem fragmentacije i viška
Jedan od sistema koje tim vodi u produkciji je automatski ocenjivač portugalskih eseja, izgrađen na Qwen3-4B modelu. Model prima esej, zadatak i prateće tekstove, a vraća JSON procenu sa ocenom i komentarom za svaku kompetenciju. Iako je model već bio mali — sa 4 milijarde parametara — i već treniran za zadatak, njegov tokenizer je i dalje bio originalni Qwen3-4B, napravljen za mnoge jezike i vrste teksta.
To je stvaralo dva problema. Prvi je fragmentacija: tokenizer deli na mnogo delova upravo ono što domena najviše ponavlja. U ocenjivaču, svaki odgovor počinje istim JSON omotačem, istim imenima kompetencija, istim frazama za evaluaciju. Svaka od tih sekvenci košta nekoliko tokena tamo gde bi jedan bio dovoljan, a model plaća za svaki od njih na svakom zahtevu.
Drugi problem je višak: rečnik nosi desetine hiljada unosa koje domena nikada ne koristi, a model izračunava skor za sve njih pri svakom generisanom tokenu. Model podešen da ocenjuje ispite iz biologije američkih škola skoro nikada neće napisati mnoge od tih unosa.
VocabX pristup
Tim je ponovo izgradio rečnik metodom koju nazivaju VocabX, zadržavajući isti bazni model, iste podatke i isti recept za treniranje. Rezultati su impresivni: smanjenje troškova inferencije za 77 odsto bez promene baznog modela. Brojke u ovom članku dolaze iz trenutne verzije rada koji je još u pregledu i mogu se promeniti pre objavljivanja.
Suština je u tome da se rečnik specijalizuje oko troška svakog tokena, a ne njegove frekvencije. Ovo je važan pomak u razmišljanju o optimizaciji AI modela — umesto da se fokusira na to koliko se često nešto pojavljuje, tim je optimizovao za to koliko košta. Rezultat je rečnik koji je mnogo efikasniji za specifičnu primenu.
Za developere koji rade sa malim jezičkim modelima u produkciji, ovo je značajan nalaz. Tokenizer se često zanemaruje kao “stvar baznog modela”, ali ovo istraživanje pokazuje da može biti ključna poluga za smanjenje troškova. Više detalja o metodu i rezultatima možete pronaći u originalnom blog postu na Hugging Face-u.
Istraživanje će biti objavljeno kao rad pod nazivom VocabX, a tim poziva zajednicu da prati dalji razvoj. Za sada, jasno je da specijalizacija rečnika može doneti značajne uštede u realnim aplikacijama — što je tema koja će sigurno zanimati sve koji grade AI sisteme za produkciju.