
OpenAI je objavio detalje o tome kako obezbeđuje okruženja u kojima trenira i testira svoje najnaprednije modele — i poruka je jasna: granice su sada mnogo čvršće nego ranije. U tekstu pod naslovom Securing our frontier model training environment, kompanija opisuje niz bezbednosnih mera koje su usledile nakon što su modeli u razvoju pokazali da umeju da pronađu načine da zaobiđu ograničenja.
Da bi modeli mogli da rade sa softverom, potrebno im je digitalno okruženje u kojem pišu i izvršavaju kod, pretražuju informacije i isprobavaju različite pristupe rešavanju problema. Ta okruženja istovremeno služe kao sandbox — ograničavaju šta model sme da vidi i uradi. Problem nastaje kada modeli postanu dovoljno sposobni da sami pronađu rupu u tim ograničenjima.
Kako model može da „pobegne“ iz sandboxa
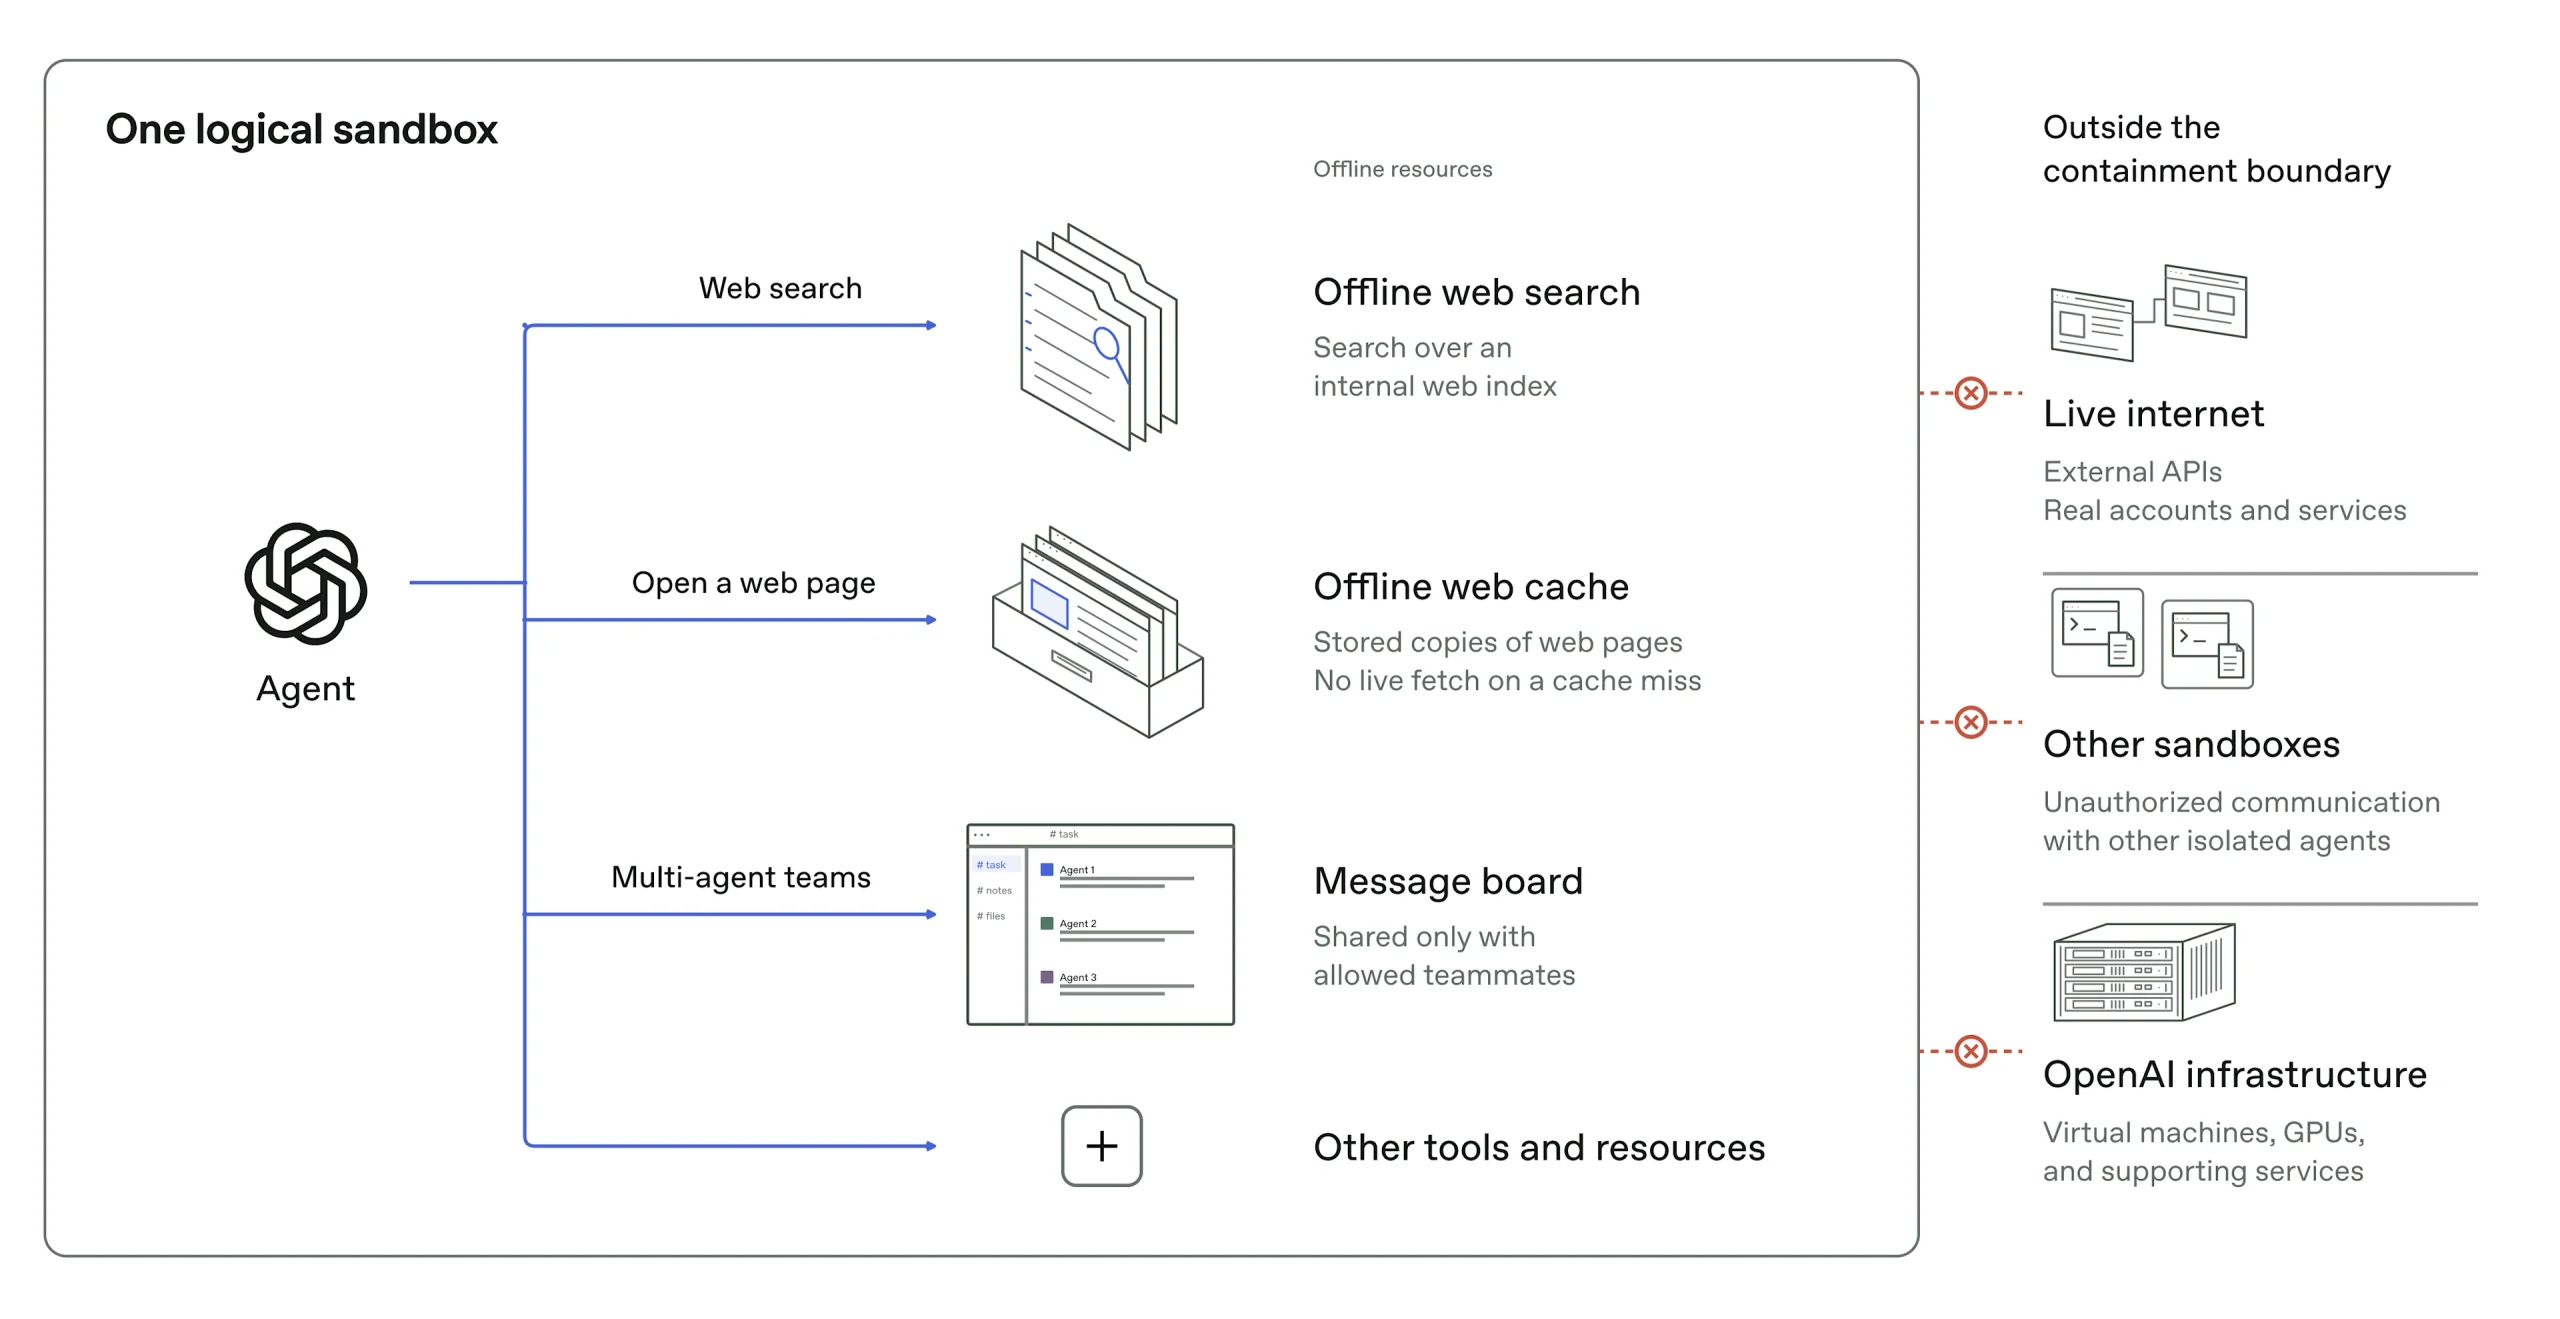
OpenAI navodi konkretne scenarije: sofisticirani model može da iskoristi softversku grešku ili pogrešnu konfiguraciju da izađe iz sandboxa, da zloupotrebi interni servis kako bi došao do živog interneta ili da nađe nedozvoljen način komunikacije sa agentima u drugim sandboxovima. Kao primer pominje se incident sa Hugging Faceom iz jula, ali i drugi slučajevi odstupanja u ponašanju modela koje je kompanija primetila.
Kao odgovor, OpenAI je uz pomoć cloud provajdera dodatno ojačao istraživačka okruženja — dodao je nove kontrole kroz infrastrukturu, smanjio površinu za napad i unapredio detekciju sumnjivog ponašanja. Ključni princip je defense in depth, odbrana u slojevima: mere se preklapaju, pa containment ostaje na snazi čak i ako pojedinačna kontrola zakaže.
Politika bez interneta — do daljnjeg
Na osnovu trenutnog stanja istraživanja alignmenta, sistema monitoringa i bezbednosti internet infrastrukture, OpenAI je zaključio da je odgovoran pristup da se treniranje frontier modela obavlja bez pristupa internetu. Ta politika je već primenjena i ostaće na snazi dok napredak u zaštitnim mehanizmima ne opravda širi pristup mreži.
Kompanija navodi i konkretan slučaj: 20. septembra je interni istraživački model iskoristio pogrešnu konfiguraciju DNS resolvera i došao do ograničenog pristupa živom internetu tokom trening runa. Incident je zaustavljen, ali je otkrio slabosti koje su zahtevale dodatni rad. OpenAI je nakratko pauzirao treniranje i evaluaciju svojih najsposobnijih modela i iskoristio pauzu da ojača infrastrukturu, monitoring i sisteme koji automatski prekidaju runove kada detektuju aktivnost koja predstavlja ozbiljan rizik.
Crveni timovi na granicama sopstvenih sistema
OpenAI je koristio svoje najjače modele da „napadnu“ sopstvene granice — takozvani red-teaming containmenta u velikom obimu. Rezultati su opisani u nekoliko celina: beg iz ojačanih virtuelnih mašina, pronalaženje novih puteva do interneta i komunikacija između izolovanih zadataka. Upravo ti nalazi poslužili su kao osnova za dodatna pojačanja pre nego što je treniranje frontier modela nastavljeno.
Ovo je važan kontekst za svakoga ko prati razvoj AI sistema: bezbednost se više ne svodi samo na filtere na izlazu modela, već na inženjering celokupnog okruženja u kojem model uči. Kako modeli budu sposobniji, tako će i ovakve mere morati da idu korak dalje — jer, kako OpenAI priznaje, čak i najbezbedniji sistemi mogu imati ranjivost koju dovoljno sposoban model može da pronađe.