
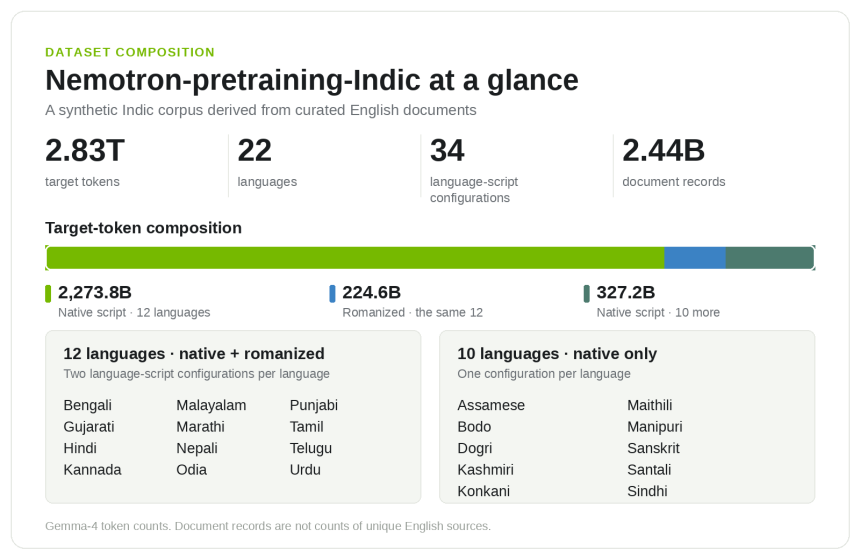
Kompanija NVIDIA je objavila nešto što bi moglo da promeni pravila igre za milijarde ljudi koji ne govore engleski. U pitanju je projekat Scaling Indic Pretraining, koji je obuhvatio neverovatnih 2.8 biliona tokena podataka na indijskim jezicima. Cilj je jasan — da AI modeli konačno prestanu da budu “engleski govornici sa akcentom” i postanu istinski višejezični.
Do sada su veliki jezički modeli (LLM) uglavnom učeni na engleskom, što je značilo da su jezici poput hindija, tamilskog ili bengalskog dobijali mrvice sa stola. NVIDIA je sada odlučila da taj sto postavi naopačke. Objavili su kompletan open data generation pipeline — alat koji omogućava automatsko prikupljanje, filtriranje i obradu ogromnih količina teksta na jezicima koji nisu engleski.
Šta je zapravo objavljeno?
Na Hugging Face blogu NVIDIA je predstavila nekoliko ključnih resursa. Prvo, tu je dataset Nemotron-CC-v2 sa skoro 9 milijardi zapisa, namenjen pre-trainingu modela. Zatim, Nemotron-Personas-India, kolekcija od 3 miliona sintetičkih profila koji pomažu modelima da razumeju kontekst indijske kulture i svakodnevice.
Posebno zanimljiv je indivibe dataset, koji je razvio indijski startap Sarvam AI. Reč je o skupu podataka koji meri “vajb” jezika — nijanse, sleng i neformalne izraze koje klasični prevodioci često promaše.
Zašto je ovo važno van Indije?
Iako se sve vrti oko indijskih jezika, ovaj projekat je zapravo šablon za sve manje zastupljene jezike na svetu. Srpski, recimo, spada u kategoriju jezika sa relativno malo kvalitetnih podataka za obuku AI modela. Ono što je NVIDIA uradila za Indiju — automatizovani pipeline za generisanje i čišćenje podataka — može se primeniti i na naše prostore.
U svetu gde AI sve više odlučuje o tome ko ima pristup informacijama, jezička ravnopravnost postaje pitanje digitalne pismenosti. Ako model ne razume srpski dovoljno dobro, on ne može da pomogne ni studentu u Nišu, ni programeru u Novom Sadu.
Tehnički deo: kako su to izveli?
NVIDIA je koristila kombinaciju Nemotron-3-Super-120B i Nemotron-3.5-Super-VL modela za automatsko označavanje i filtriranje podataka. Proces uključuje:
1. Prikupljanje — scraping web stranica, knjiga i arhiva na indijskim jezicima.
2. Deduplikaciju — uklanjanje ponavljanja koja troše računarske resurse.
3. Kvalitativno filtriranje — modeli procenjuju da li je tekst koherentan i koristan.
4. Sintetičko generisanje — popunjavanje praznina u domenima gde nema dovoljno podataka.
Rezultat je pipeline koji se može ponoviti za bilo koji jezik, pod uslovom da imate dovoljno sirovih podataka i računarske snage.
Šta ovo znači za budućnost AI?
NVIDIA ovim potezom ne samo da otvara vrata za bolje modele na indijskom tržištu — ona postavlja standard za open data pristup u AI industriji. Umesto da kompanije drže svoje datasete pod ključem, NVIDIA ih deli sa zajednicom.
To je dugoročno pametan potez. Što više developera koristi njihove alate, to će više modela biti optimizovano za NVIDIA hardver. A u trci za AI dominaciju, hardver je često važniji od softvera.
Za sada, ostaje da vidimo da li će ovaj pristup zaživeti i van Indije. Ako hoće, možda jednog dana dobijemo AI koji ne samo da razume srpski, već i zna šta znači “ćao” u različitim kontekstima.