
Liquid AI je objavio novi pristup ubrzavanju vizuelno-jezičkih modela (VLM) pod nazivom LFM2.5-VL-DSpark. Reč je o tehnici takozvanog spekulativnog dekodiranja koja omogućava da modeli koji istovremeno obrađuju slike i tekst rade značajno brže, a da pritom ne izgube na kvalitetu odgovora.
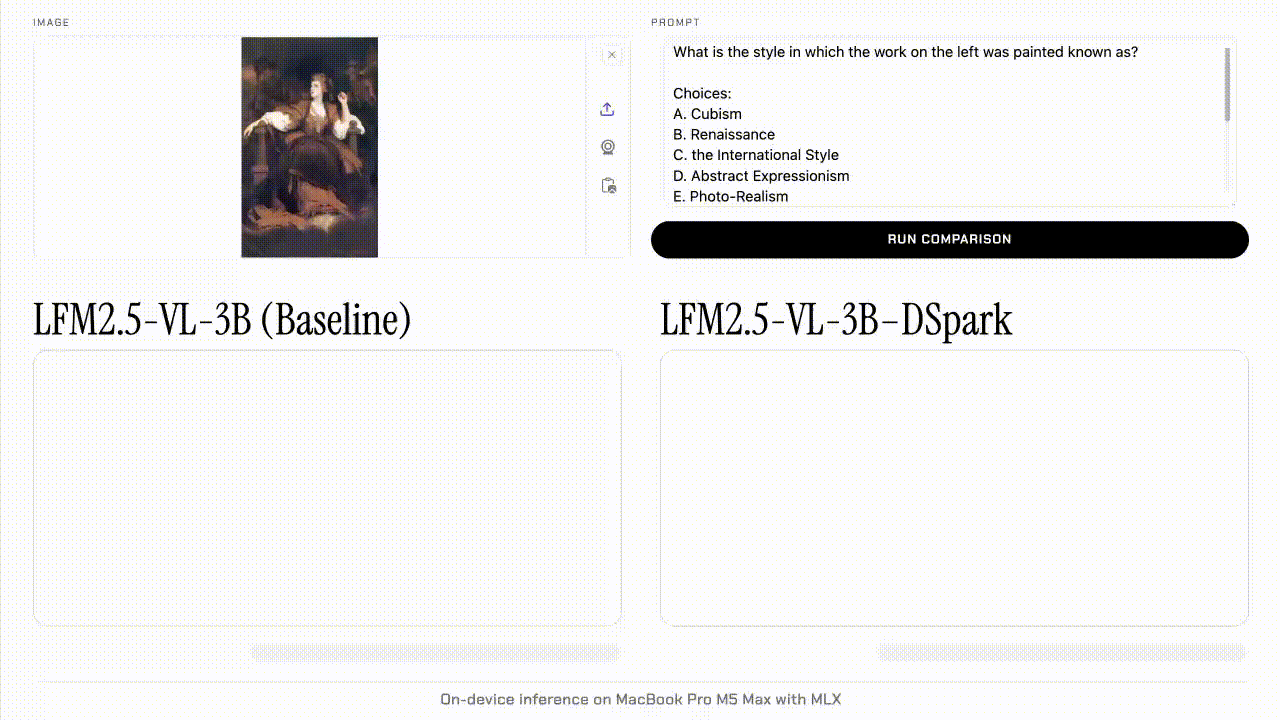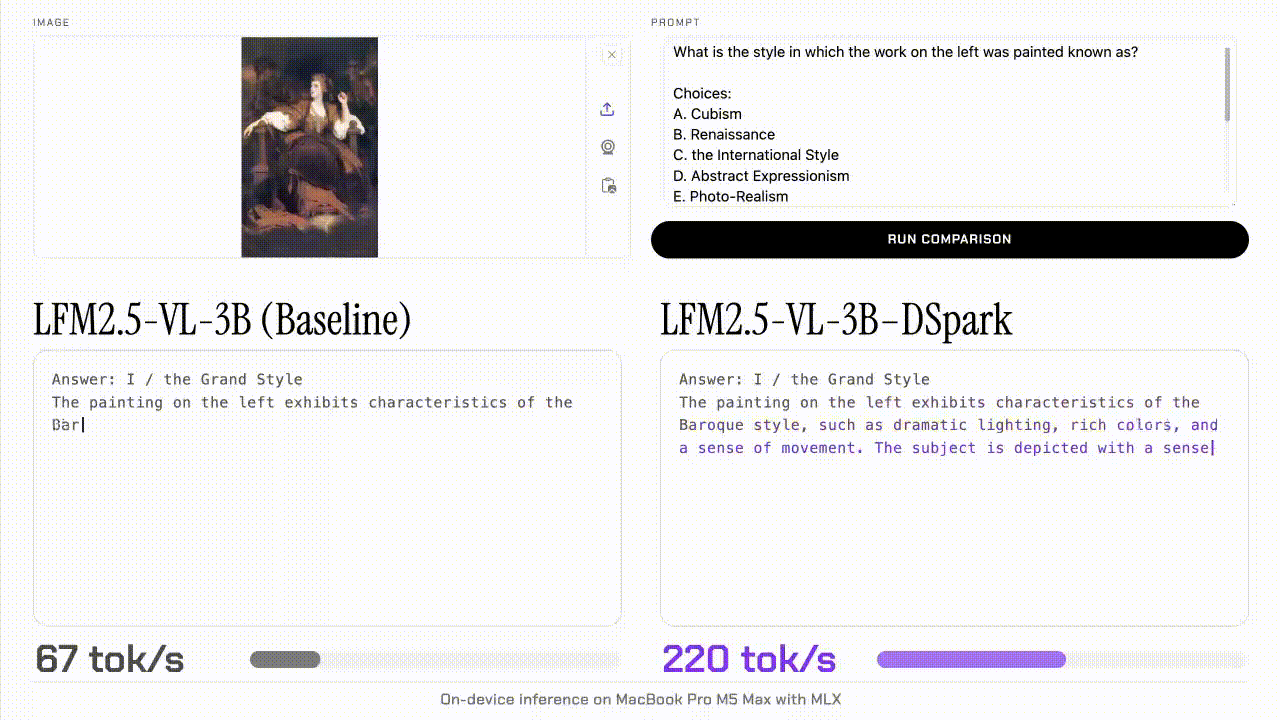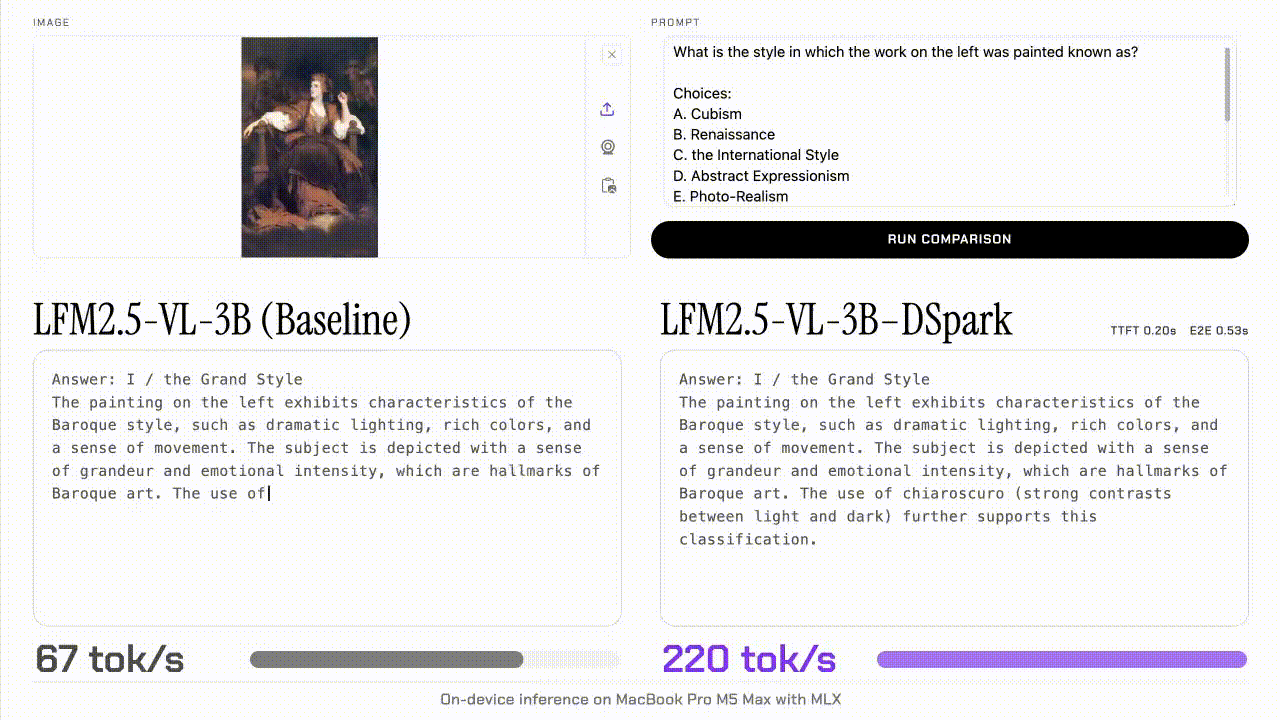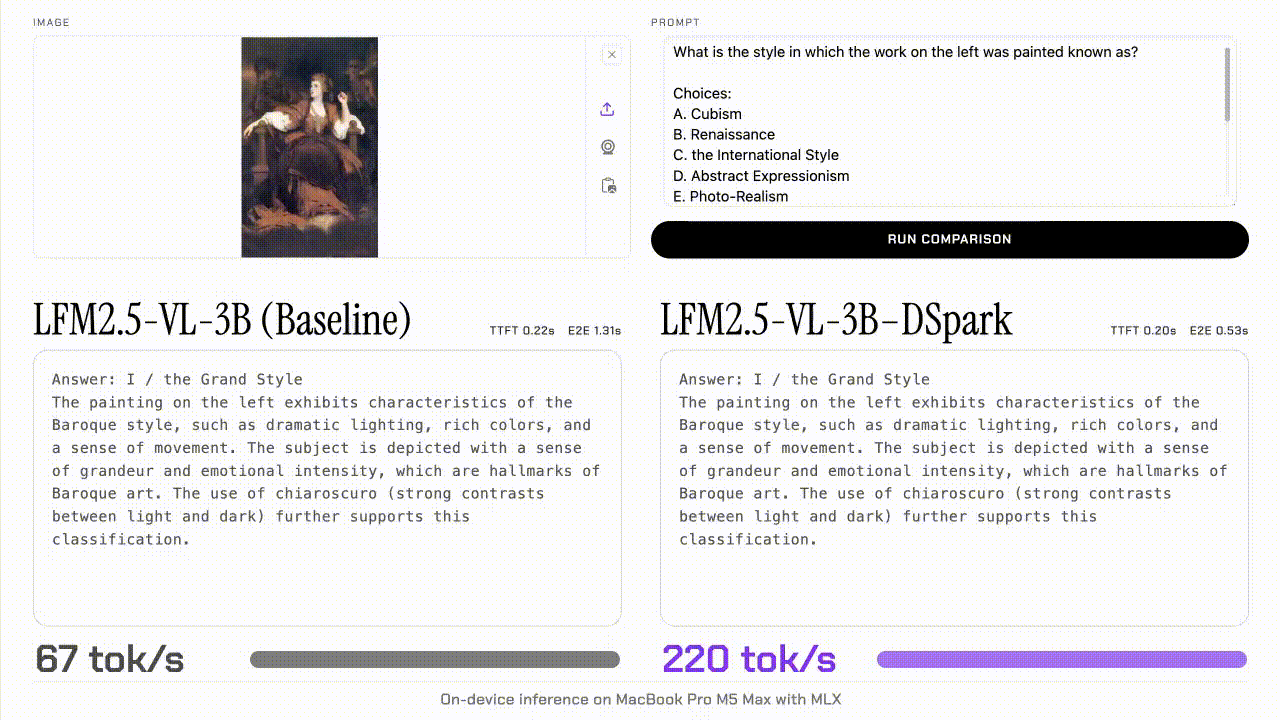
Ako pratite svet veštačke inteligencije, verovatno vam je poznat problem: veliki modeli su moćni, ali spori i skupi za izvršavanje. Spekulativno dekodiranje rešava taj problem tako što mali, brzi „nacrtni” model predlaže nekoliko sledećih tokena, a veliki model ih onda samo verifikuje u jednom prolazu. Umesto da veliki model računa svaki token pojedinačno, on praktično potvrđuje ili odbacuje predloge — što drastično ubrzava rad.
Isti trik, nova primena
Ono što Liquid AI sada radi jeste prenošenje tog pristupa iz sveta čistog teksta u svet vizuelno-jezičkih modela. Prema objašnjenju jednog od članova tima u komentarima na Hugging Face blogu, vizuelni „drafter” koristi istu arhitekturu kao i tekstualni LFM2.5-DSpark modeli. On hvata skrivena stanja ciljnog modela na fiksiranom skupu slojeva i na osnovu njih gradi blok od k kandidata za sledeće tokene.
Ključni trik je u tome što se isečci slike i tekstualni tokeni projektuju u zajedničku reprezentaciju pre tih slojeva. Zahvaljujući tome, drafter radi sa skrivenim vektorima identične dimenzionalnosti bez obzira na to da li na ulazu ima sliku ili tekst. Drugim rečima — algoritam zaključivanja ostaje nepromenjen u odnosu na tekstualne modele, što ceo sistem čini mnogo jednostavnijim za održavanje i ponovnu upotrebu.
Koliko je zapravo brže?
Rezultati su konkretni i lako uporedivi. Prema podacima sa bloga, ubrzanje dostiže do 3,13 puta na uređajima (on-device) i do 2,66 puta na NVIDIA H100 grafičkom procesoru. Ono što je možda i važnije od samih brojeva — dodatni zahtevi za memorijom ostaju relativno mali, a kvalitet izlaza se ne menja.
Uz to, tu su i konkretni modeli koje možete probati odmah:
LFM2.5-VL-3B je osnovni model sa oko 3 milijarde parametara, dok je LFM2.5-VL-3B-DSpark znatno lakši — svega oko 0,3 milijarde parametara — i upravo on služi kao brzi drafter. Tu je i GGUF verzija istog modela, namenjena lokalnom izvršavanju.
Podrška od prvog dana
Za developere je posebno zanimljivo to što novi modeli imaju podršku „od prvog dana” u alatima kao što su llama.cpp, MLX-VLM i SGLang. To znači da možete eksperimentisati sa lokalnim i ubrzanim VLM zaključivanjem bez čekanja na dodatne integracije.
Uz modele su objavljena i dva relevantna naučna rada: MMSpec, koji se bavi benchmarkovanjem spekulativnog dekodiranja za vizuelno-jezičke modele, i DSpark, koji opisuje tehniku zakazivanja spekulativnog dekodiranja sa poluautoregresivnim generisanjem.
Šta ovo znači u praksi?
Vizuelno-jezički modeli su sve prisutniji — od analize dokumenata i medicinskih slika do asistenata koji „gledaju” i odgovaraju na pitanja. Problem je što su često prespori i preskupi za široku primenu, naročito na telefonima i laptopovima bez moćnih GPU-ova. Ako se ubrzanje od preko tri puta pokaže stabilnim i na različitim hardverima i zadacima, to bi mogao biti jedan od onih koraka koji VLM-ove prevodi iz laboratorija u svakodnevnu upotrebu.
Liquid AI očigledno gradi kontinuitet — prethodno su objavili slično ubrzanje za tekstualne modele, a sada istu ideju šire na multimodalnost. Ostaje da se vidi kako će se ovi dobici preneti na različite uređaje i realne scenarije, ali smer je jasan: brže, jeftinije i praktičnije veštačka inteligencija koja vidi i razume.