
Kada AI model pogreši, prva asocijacija je halucinacija — izmišljanje činjenica koje nigde ne postoje. Ali istraživači iz kompanije Multiverse Computing upozoravaju na mnogo podmukliji problem: situaciju u kojoj je informacija tačna, ali je pripisana pogrešnom izvoru. Rezultat? Odgovor koji deluje savršeno utemeljen, a zapravo je obična zamena teza.
U svom novom radu pod nazivom ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents, tim predstavlja pristup koji ne proverava samo da li je tvrdnja tačna, već i da li je vezana za pravi izvor. Ključna poruka je jednostavna, ali nezgodna za industriju: grounded ne znači isto što i tačno pripisano.
Zamka koju standardni testovi ne vide
Zamislite AI agenta koji povlači podatke iz više alata — recimo, iz baze korisničkih naloga i iz internog pravilnika o refundacijama. Agent generiše odgovor u kome navodi da rok za povraćaj novca iznosi 30 dana i kao izvor navede korisnički nalog. Problem: taj podatak postoji u pravilniku, ali ne i u nalogu. Činjenica je tačna, ali citirani izvor je pogrešan.
Ovakav scenario prolazi kroz većinu današnjih evaluacija. Sistem vidi da tvrdnja postoji negde u skupu izlaza alata i označi je kao „utemeljenu”. Source-blind provera vernosti ostaje zelena, iako je odgovor zapravo obmanjujuć. U svetu u kome se AI agenti sve više oslanjaju na lance alata i eksternih servisa, ovo nije teorijski problem — to je svakodnevna operativna realnost.
Šta ProvenanceGuard radi drugačije
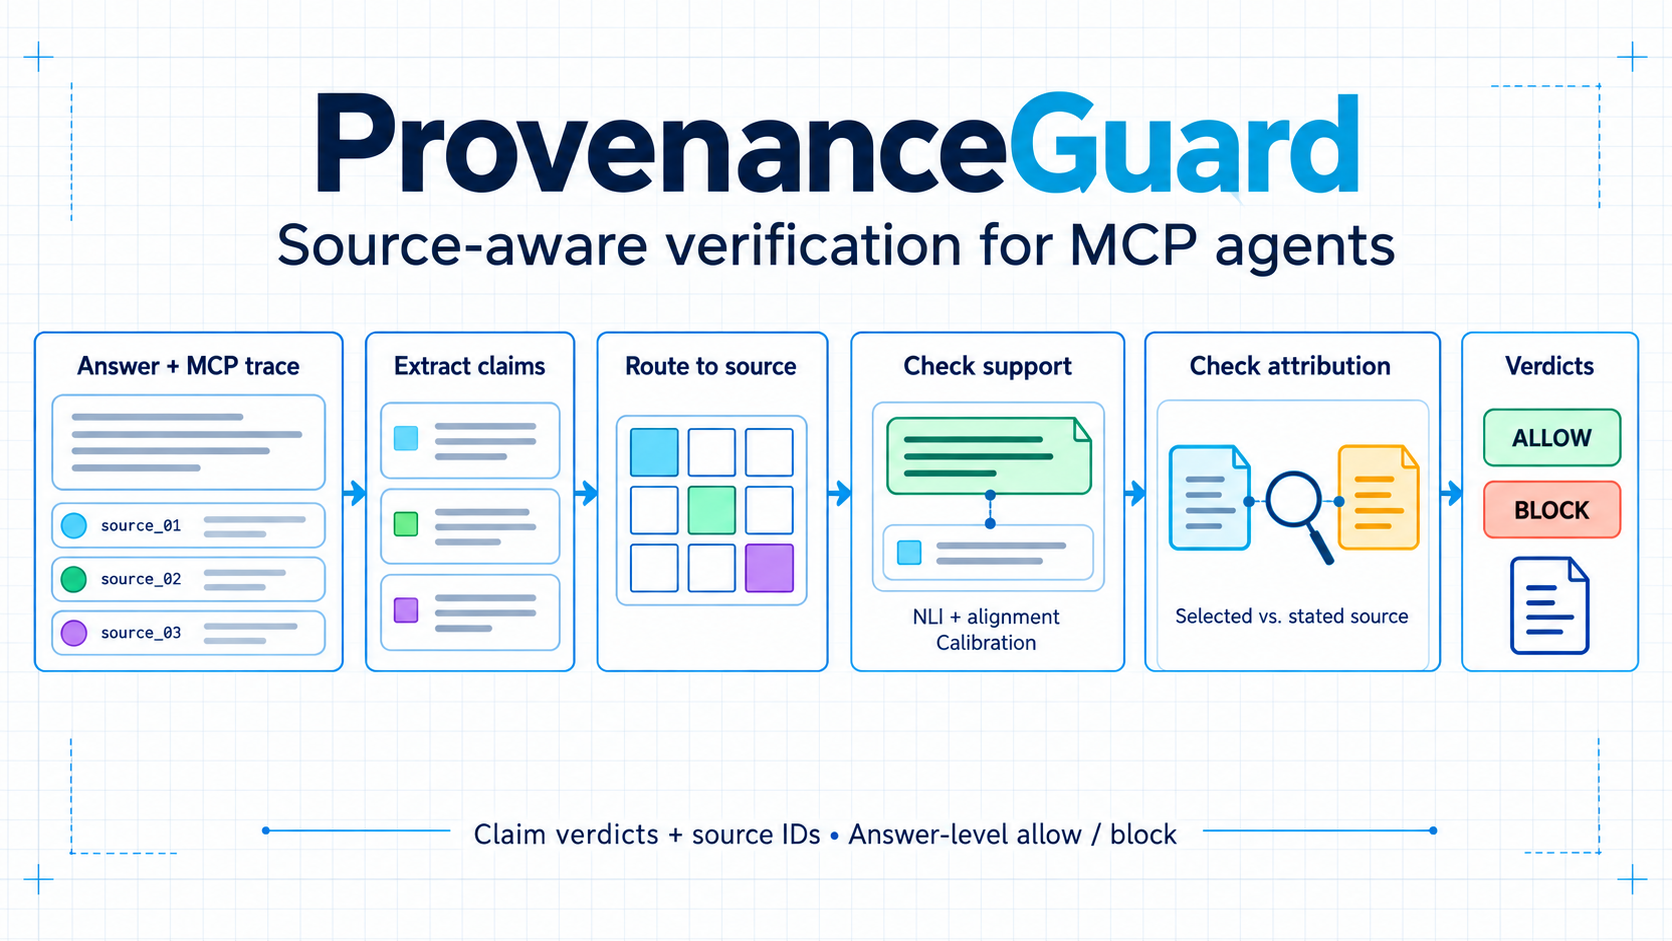
Rešenje koje predlažu autori nije samo još jedan sloj provere, već promena samog ugovora između agenta i sistema za verifikaciju. Umesto da se tvrdnje proveravaju „u masi”, ProvenanceGuard zadržava ID izvora i alata kroz ceo proces: od razlaganja odgovora na pojedinačne tvrdnje, preko provere podrške, do provere pripisivanja. Na kraju, svaka tvrdnja dobija sopstvenu oznaku — dozvoljena ili blokirana — koju čovek može da pregleda.
Autori u komentarima ispod rada pojašnjavaju suštinu: kada sistem kaže da je odgovor „grounded”, to mora da znači da ga podržava izvor koji je u odgovoru naveden, a ne bilo koji izlaz alata. Razlika između ta dva kriterijuma je, kako navode, razlika između dva različita nivoa puštanja u produkciju.
Zašto ne jednostavno — drugi LLM da proveri?
Najčešće pitanje koje se nameće jeste: zar ne bi bilo lakše pustiti još jedan jeftiniji LLM da presudi o tome? Autori priznaju da u radu nemaju direktno poređenje sa takvim pristupom, ali iznose ključni argument — LLM sudija može i sam da pogreši. Uvođenje generativne provere unosi nove greške, uključujući upravo one vrste zabune izvora koje sistem treba da uhvati.
Zato ProvenanceGuard koristi eksplicitno praćenje izvora i kalibrisane provere podrške, umesto da se oslanja na još jednu generativnu procenu. Pristup kombinuje embedding modele za pronalaženje verovatnog izvora, NLI modele i random forest klasifikator za proveru da li taj izvor zaista podržava tvrdnju.
Šta to znači za timove koji grade AI agente
Praktičan zahtev za inženjere koji povezuju MCP agente je jasan: kada vaša evaluacija kaže „grounded”, proverite da li mislite na podržano od strane bilo kog alata ili podržano od strane izvora koji je odgovor naveo. U okruženjima sa više alata, druga opcija je ona koja hvata mešanje izvora pre nego što čovek poveruje citatu.
U eri u kojoj AI agenti sve samostalnije donose odluke i generišu odgovore na osnovu desetina izvora, pitanje nije samo da li je informacija tačna. Pitanje je — kome je pripisujemo. I upravo tu se krije razlika između sistema kome možete verovati i onog koji samo dobro zvuči.